Vier Werkzeuge, vier Aufgaben, ein hartnäckiges Missverständnis
Was wäre, wenn du auf deiner Website einen Bereich hättest, den niemand in Google finden soll. Du trägst ihn in die robots.txt ein. Zur Sicherheit setzt du auf jede Seite auch noch ein noindex. Doppelt hält besser, oder?
Drei Wochen später suchst du nach deinem Firmennamen und siehst eine dieser Seiten im Suchergebnis. Ohne Beschreibung, aber unübersehbar da.
Das ist kein Google Fehler. Das ist die berühmteste Verwechslung der technischen SEO. Die Sperre in der robots.txt verhindert, dass Google die Seite öffnet. Und weil Google sie nicht öffnen darf, liest es das noindex nie. Deine beiden Schlösser arbeiten gegeneinander.
Dieser Dreamcodes Guide räumt mit genau solchen Missverständnissen auf. So gründlich, dass du danach nie wieder raten musst, welches Werkzeug du wann brauchst.
Die schnelle Antwort Vorab
Canonical, Noindex, robots.txt und Sitemap sind vier verschiedene Werkzeuge der technischen SEO, die vier verschiedene Probleme lösen:
- Canonical nennt Google die bevorzugte URL, wenn mehrere Adressen denselben oder fast denselben Inhalt zeigen.
- Noindex verhindert, dass eine Seite in den Suchindex aufgenommen wird.
- robots.txt steuert, welche URLs der Crawler überhaupt abrufen darf.
- Sitemap meldet Google die URLs, die für deine Website wichtig sind.
Keines der vier ersetzt ein anderes. Genau das ist der eigentliche rote Faden dieses Guides: Wer sie verwechselt, baut sich Fehler ein, die man oft monatelang nicht bemerkt, weil die Website ja scheinbar normal läuft.
Ein Bild, das dich durch den ganzen Guide begleitet
Stell dir Google als sehr fleißigen Bibliothekar vor. Er läuft den ganzen Tag mit einem Wagen durch deine Bibliothek, schaut sich Bücher an und entscheidet, welche in den Katalog kommen.
- Die robots.txt ist das Schild an der Lagertür: Zutritt nur für Personal. Der Bibliothekar geht nicht hinein.
- Noindex ist ein Zettel im Buch: Bitte nicht in den Katalog aufnehmen. Er muss das Buch aber aufschlagen dürfen, um den Zettel zu lesen.
- Canonical ist der Vermerk: Dieses Exemplar ist die Hauptausgabe, alle anderen Kopien gehören dazu.
- Die Sitemap ist die Liste der Neuerscheinungen am Empfang: Schau bitte hier zuerst vorbei. Ob ein Buch in den Katalog kommt, entscheidet der Bibliothekar trotzdem selbst.
Wenn du dir dieses Bild merkst, hast du die Hälfte des Guides schon verstanden. Die andere Hälfte sind Details, Fallen und Praxis. Und davon gibt es reichlich.
Warum diese vier ständig verwechselt werden
Dafür gibt es handfeste Gründe, und es liegt nicht an dir:
- Alle vier drehen sich um die Frage, was Google mit einer URL tun soll. Das klingt ähnlich, ist aber jedes Mal eine andere Frage.
- Sie sehen im Alltag ähnlich aus. Zwei sitzen im HTML Head, eine ist eine Textdatei, eine ist eine XML Datei. Wer nicht weiß, wofür welche da ist, behandelt sie wie austauschbare Schalter.
- Viele Tutorials werfen sie in einen Topf. Ein Satz wie Sperre die Seite für Google ist ungefähr so hilfreich wie Mach die Heizung bitte irgendwie anders.
- Fehler zeigen sich spät. Ein falsches Canonical oder ein vergessenes noindex fällt erst auf, wenn Rankings wegbrechen oder Seiten fehlen. Dann sind oft Wochen vergangen.
- Alltagssprache verwischt die Begriffe. Google findet meine Seite nicht kann bedeuten: nicht entdeckt, nicht gecrawlt, nicht indexiert oder nicht gut genug platziert. Vier völlig verschiedene Probleme, ein Satz.
Der wichtigste Unterschied: Crawlen ist nicht Indexieren
Wenn du aus diesem Guide nur einen Gedanken mitnimmst, dann bitte diesen:
- Crawling bedeutet, dass Google eine URL abruft und den Inhalt liest.
- Indexierung bedeutet, dass Google die Seite in seinen Suchindex aufnimmt und sie damit überhaupt als Suchergebnis in Frage kommt.
Das sind zwei getrennte Schritte. Eine Seite kann gecrawlt, aber nicht indexiert werden (typisch bei noindex). Eine URL kann indexiert sein, obwohl Google sie nie lesen durfte (typisch bei robots.txt Sperren, wenn andere Seiten auf sie verlinken). Und eine Seite kann in deiner Sitemap stehen und trotzdem nie im Index landen.
Und das ist, was die vier Werkzeuge jeweils beeinflussen:
- robots.txt wirkt auf das Crawling, nicht direkt auf die Indexierung.
- Noindex wirkt auf die Indexierung, setzt aber voraus, dass gecrawlt werden darf.
- Canonical wirkt auf die Auswahl der URL, die aus einer Gruppe ähnlicher Seiten im Index landet.
- Sitemap wirkt auf die Entdeckung von URLs, mehr nicht.
Was du in diesem Guide lernst
Wir gehen Schritt für Schritt vor, und jedes Kapitel baut auf dem vorigen auf:
- Wie Google eine URL entdeckt, abruft, verarbeitet und bewertet (Kapitel 2)
- Wie Canonical wirklich funktioniert und warum Google es auch ignorieren darf (Kapitel 3)
- Wie du mit Noindex per Meta Tag und per HTTP Header sauber steuerst, was im Index landet (Kapitel 4)
- Was die robots.txt kann, was sie nicht kann und welche Fehler Websites ganze Rankings kosten (Kapitel 5)
- Wann eine XML Sitemap hilft und wann sie nur Ballast ist (Kapitel 6)
- Der direkte Vergleich mit Merksätzen, die du dir nie wieder neu herleiten musst (Kapitel 7)
- Sechs Szenarien, in denen die Werkzeuge zusammenspielen, zehn Praxisfehler und eine komplette Beispielkonfiguration (Kapitel 8 bis 10)
- Eine Checkliste, ein Prüfablauf für jede Website, eine ausführliche FAQ und ein Fazit zu dieser Thematik (Kapitel 11 bis 14)
Egal, ob du gerade deine erste Website betreust oder seit Jahren SEO machst: Die Grundlagen stehen vorn, die Grenzfälle für Fortgeschrittene und Profis kommen in den Praxiskapiteln und in den Expertentipps.
Bevor wir die vier Werkzeuge einzeln auseinandernehmen, müssen wir kurz hinter die Kulissen schauen. Denn nur wer weiß, was Google mit einer URL macht, versteht, an welcher Stelle welches Werkzeug eingreift.
Die drei Schritte bei Google: Crawling, Indexierung und Ranking
Google ist keine Zauberkiste, in die du eine Seite wirfst und oben ein Ranking herausfällt. Dahinter steckt eine Kette aus mehreren Stationen, und jede Station hat ihre eigenen Regeln. Wer die Kette kennt, versteht plötzlich, warum Sitemap, robots.txt, Noindex und Canonical an so unterschiedlichen Stellen eingreifen.
Der Weg einer URL: Von der Entdeckung bis zum Suchergebnis
Google verarbeitet jede URL in vier Stufen: Es entdeckt sie (Discovery), ruft sie ab und verarbeitet sie (Crawling), entscheidet über die Aufnahme in den Suchindex (Indexierung) und bewertet sie für konkrete Suchanfragen (Ranking). Jede Stufe kann eine URL stoppen, und jedes unserer vier Werkzeuge sitzt an einer anderen Stufe.
Hier siehst du den Weg einer URL im Überblick:
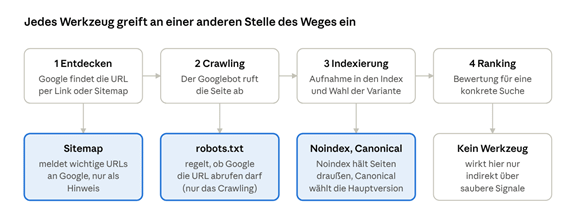
Weg einer URL bei Google · 4 Stufen, 3 Werkzeuggruppen
Die Sitemap wirkt bei der Entdeckung, die robots.txt beim Crawling, Noindex und Canonical bei der Indexierung. Beim Ranking greift keines der vier direkt ein.
Discovery: Wie findet Google eine URL?
Bevor Google irgendetwas abruft, muss es wissen, dass die URL existiert. Dafür gibt es mehrere Wege:
- Interne Links: Die stärkste und zuverlässigste Quelle. Eine Seite, die von wichtigen Seiten deiner Website verlinkt wird, wird zuverlässig gefunden.
- Externe Links: Andere Websites verlinken auf dich. Das gilt übrigens auch für Links auf Seiten, die du lieber geheim halten würdest.
- XML Sitemap: Du lieferst Google eine Liste der URLs, die dir wichtig sind.
- Weiterleitungen, Canonical Angaben und hreflang: Auch hier tauchen URLs auf, die Google dann auf seine Liste setzt.
- Search Console: Über die URL Prüfung kannst du eine einzelne Adresse zur Indexierung anfragen.
Die Sitemap ist also nur einer von mehreren Entdeckungswegen. Seiten, die weder verlinkt noch in einer Sitemap sind, nennt man Waisenseiten (englisch Orphan Pages). Sie werden oft spät oder gar nicht gefunden.
Ein Klassiker aus der Praxis: Ein Testsystem unter einer Subdomain wird einmal verlinkt, zum Beispiel in einer E Mail oder einem Forum, und taucht Wochen später in Google auf. Entdeckt heißt eben nicht, dass du es so wolltest.
Crawling: Darf und kann Google die Seite abrufen?
Crawling bedeutet, dass der Googlebot eine URL per HTTP abruft und den Inhalt herunterlädt. Bevor er das tut, schaut er in die robots.txt deiner Domain. Steht dort ein Verbot für diese URL, ruft er sie nicht ab. Damit endet die Reise für diese URL an dieser Stelle, zumindest was den Inhalt betrifft.
Wird abgerufen, spielt der HTTP Statuscode eine große Rolle: 200 heißt alles in Ordnung, 301 und 308 heißen dauerhaft umgezogen, 404 und 410 heißen nicht vorhanden, 5xx heißen Serverproblem.
Dazu kommt das Crawl Budget. Das ist grob gesagt die Menge an Abrufen, die Google für deine Website bereit ist zu investieren. Sie hängt davon ab, wie viel dein Server verträgt und wie interessant deine Inhalte für Google sind. Nach Googles eigener Einschätzung ist das Crawl Budget vor allem bei sehr großen Websites mit vielen Tausend Seiten ein Thema. Bei einem Blog mit 200 Artikeln musst du dir darüber keine schlaflosen Nächte machen. Bei einem Shop mit Filtern, die Millionen URL Varianten erzeugen, schon.
Verarbeitung und Rendering: Was Google wirklich liest
Nach dem Abruf analysiert Google das HTML. Viele Seiten bauen ihre Inhalte aber erst per JavaScript zusammen. Deshalb führt Google einen Teil der Seiten in einem zweiten Schritt in einer Art unsichtbarem Browser aus, dem sogenannten Rendering.
Wichtig für unser Thema: Canonical Tags, Meta Robots Angaben und Links werden aus dem HTML gelesen. Steht im ursprünglichen HTML bereits ein noindex, kann Google sich das Rendering sparen. Ein noindex, das du per JavaScript wieder entfernen willst, ist deshalb eine unzuverlässige Idee. Setze Steueranweisungen immer direkt in der Serverantwort.
Indexierung: Kommt die Seite in den Suchindex?
Der Index ist Googles riesige Datenbank, aus der Suchergebnisse zusammengestellt werden. Hier greifen Noindex und Canonical:
- Steht auf der Seite noindex, nimmt Google sie nicht auf (oder entfernt sie später wieder).
- Gibt es mehrere sehr ähnliche Seiten, bildet Google eine Gruppe und wählt eine kanonische URL aus. Nur diese wird normalerweise gezeigt.
Und jetzt kommt eine Wahrheit, die viele überrascht: Google indexiert nicht alles, was es crawlt. Seiten mit dünnen oder doppelten Inhalten, geringem Nutzen oder technischen Problemen landen oft im Wartezustand. Die Search Console zeigt das als Gecrawlt, zurzeit nicht indexiert.
Ranking: Wo steht die Seite im Ergebnis?
Erst wenn eine Seite im Index ist, kann sie ranken. Hier entscheiden viele Signale: Relevanz für die Suchanfrage, Qualität und Vertrauenswürdigkeit des Inhalts, Nutzerfreundlichkeit, Links und mehr.
Die vier Werkzeuge dieses Guides verbessern dein Ranking nicht direkt. Sie sorgen dafür, dass die richtige URL im Index steht, dass Signale nicht auf mehrere Varianten verteilt werden und dass Google seine Zeit nicht mit Unsinn verbringt. Indirekt ist das eine Menge wert, nur eben kein Ranking Booster per Knopfdruck.
Was die Search Console dir erzählt
Im Bericht Seitenindexierung der Google Search Console siehst du, an welcher Stufe URLs hängen bleiben. Die wichtigsten Meldungen auf einen Blick:
| Meldung in der Search Console | Was sie bedeutet | Typische Ursache |
| Durch robots.txt blockiert | Google durfte die URL nicht abrufen | Disallow Regel in der robots.txt |
| Ausgeschlossen durch noindex Tag | Google hat die Seite gelesen und bewusst nicht indexiert | Meta Robots oder X Robots Tag mit noindex |
| Alternative Seite mit richtigem kanonischen Tag | Google folgt deinem Canonical auf eine andere URL | Canonical zeigt auf eine bevorzugte Version |
| Duplikat, Google hat eine andere Seite als kanonische Seite ausgewählt | Google ignoriert deine Angabe oder hat keine gefunden | Widersprüchliche Signale oder fast identische Inhalte |
| Gecrawlt, zurzeit nicht indexiert | Abgerufen, aber noch nicht aufgenommen | Qualität, Duplikate, wenig Nutzen |
| Gefunden, zurzeit nicht indexiert | Bekannt, aber noch nicht gecrawlt | Crawl Budget, schwache interne Verlinkung |
| Seite mit Weiterleitung | URL leitet um und wird nicht indexiert | 301 oder 302 Weiterleitung |
| Indexiert, obwohl durch robots.txt blockiert | URL steht im Index, Inhalt kennt Google nicht | Blockiert, aber von anderen Seiten verlinkt |
Die genauen Bezeichnungen können sich ändern, die Logik dahinter bleibt aber gleich. Wenn du die Tabelle verinnerlichst, kannst du Meldungen künftig direkt einer Stufe im Weg der URL zuordnen.
Warum eine Sitemap keine Indexierung erzwingt
Die Sitemap wirkt nur in der Discovery Stufe. Sie sagt Google: Diese URL existiert und ist mir wichtig. Ob Google die Seite dann abruft, aufnimmt und rankt, hängt von allem ab, was danach kommt, vor allem von Qualität und Nutzen. Die Sitemap ist ein Hinweis, kein Befehl. Dazu später mehr in Kapitel 6.
Warum Noindex kein Ersatz für robots.txt ist
Noindex wirkt in der Indexierungsstufe, robots.txt in der Crawling Stufe. Um das noindex zu lesen, muss Google die Seite erst abrufen. Wer das Abrufen verbietet, versteckt den Zettel im Buch vor dem Bibliothekar. Und umgekehrt: Noindex spart kein Crawling, denn Google muss die Seite ja weiterhin regelmäßig abrufen, um zu prüfen, ob das noindex noch da ist.
Ein Tipp von unserer Seite: Das Serverlog ist die ehrlichste Quelle
Die Search Console zeigt dir, was Google berichtet. Das Serverlog zeigt dir, was tatsächlich passiert ist. Dort siehst du jeden Abruf des Googlebots mit Zeitpunkt, URL und Statuscode. Bei größeren Websites findest du hier Crawl Verschwendung (Parameter URLs, Filter, Kalenderseiten) und Seiten, die Google nie besucht. Achte darauf, echte Googlebot Zugriffe von gefälschten zu unterscheiden, zum Beispiel per Reverse DNS Abfrage, denn der User Agent allein lässt sich beliebig vortäuschen.
Jetzt kennst du die Stationen. Zeit, das erste Werkzeug auseinanderzunehmen, und zwar das, das am häufigsten missverstanden wird: das Canonical.
Canonical: Welche URL ist die bevorzugte Version?
Stell dir vor, dein bester Artikel ist unter fünf verschiedenen Adressen erreichbar. Einmal sauber, einmal mit Tracking Parameter aus dem Newsletter, einmal als Druckversion, einmal mit http statt https und einmal mit www. Für dich ist das derselbe Artikel. Für Google sind das fünf verschiedene URLs. Und jetzt muss es sich entscheiden, welche es zeigen soll.
Genau dafür gibt es das Canonical.
Was bedeutet Canonical?
Ein Canonical (auch kanonische URL oder Canonical Tag genannt) ist eine Angabe im HTML Head einer Seite, die Google mitteilt, welche URL aus einer Gruppe gleicher oder sehr ähnlicher Seiten die bevorzugte Hauptversion ist. Google soll diese URL indexieren und in den Suchergebnissen zeigen, die anderen Varianten gelten als Duplikate.
Ein konkretes Beispiel. Diese vier Adressen liefern alle denselben Artikel:
https://www.beispiel.de/artikel/
https://www.beispiel.de/artikel/?utm_source=newsletter
https://www.beispiel.de/artikel/?sortierung=neu
https://www.beispiel.de/artikel/drucken/
Mit einem Canonical auf die erste Adresse sagst du Google: Das ist die Hauptversion, bitte bündle alles dort.
Warum entsteht überhaupt Duplicate Content?
Duplicate Content (doppelter Inhalt) entsteht meist ganz ohne böse Absicht, und zwar technisch:
- URL Parameter für Tracking, Sortierung, Filter, Sitzungen
- Mehrere Pfade zum selben Inhalt (Kategorie A und Kategorie B zeigen dasselbe Produkt)
- http und https oder www und ohne www gleichzeitig erreichbar
- Mit und ohne Schrägstrich am Ende, Groß und Kleinschreibung im Pfad
- Druckversionen, mobile Subdomains, Kommentar und Paginierungsseiten
- Syndizierte Inhalte, also Artikel, die auf mehreren Websites erscheinen
Ein weit verbreiteter Mythos: Duplicate Content führe zu einer Strafe. In der Regel ist das nicht der Fall. Das eigentliche Problem ist ein anderes: Google muss raten, welche Variante es zeigt, und deine Signale (Links, Aufrufe, Relevanz) verteilen sich auf mehrere URLs, statt sich auf eine zu konzentrieren. Du verwässerst dich selbst.
So funktioniert rel canonical
Der Standard ist ein Link Element im Head der Seite:
<link rel=“canonical“ href=“https://www.beispiel.de/artikel/“>
Drei Regeln, die du dir einprägen solltest:
- Nur im Head. Ein Canonical im Body wird ignoriert.
- Absolute URL mit Protokoll. Also komplett mit https und Domain. Relative Pfade funktionieren manchmal, sind aber fehleranfällig.
- Nur ein Canonical pro Seite. Mehrere widersprüchliche Angaben führen dazu, dass Google sie alle ignorieren kann.
Für Dateien ohne HTML, etwa PDFs, gibt es eine Variante im HTTP Header:
Link: <https://www.beispiel.de/downloads/handbuch.pdf>; rel=“canonical“
Außerdem gilt: Auch die Aufnahme einer URL in die Sitemap ist ein (schwächeres) Canonical Signal. Und eine 301 Weiterleitung ist ein sehr starkes. Dazu gleich mehr.
Wann solltest du Canonical einsetzen?
Immer dann, wenn mehrere URLs denselben oder nahezu denselben Inhalt liefern und alle erreichbar bleiben sollen. Die typischen Fälle:
- URLs mit Parametern: Ein Parameter, der den Inhalt nicht verändert (zum Beispiel eine Session ID), bekommt ein Canonical auf die URL ohne Parameter.
- Tracking Parameter: Alles mit utm_source, utm_medium, fbclid und Co. zeigt per Canonical auf die saubere URL.
- Druckversionen: Die Druckansicht verweist auf die normale Artikelseite.
- Sortierungen und Filter: Eine nach Preis sortierte Produktliste zeigt nahezu dieselben Produkte wie die Standardliste. Canonical auf die Standardversion, sofern der Filter keinen eigenen Suchbedarf bedient.
- Ähnliche oder nahezu identische Inhalte: Produktvarianten wie ein T Shirt in sieben Farben, bei denen nur die Farbe im Titel wechselt.
- Syndizierte Inhalte: Wenn dein Artikel auf einer anderen Website erscheint, kann diese per Canonical auf dein Original verweisen (sogar domainübergreifend).
Und was ist mit http zu https und www zu ohne www? Hier ist das Canonical nur die zweite Wahl. Besser ist eine serverseitige 301 Weiterleitung, weil dann auch Besucher und Links sauber auf der Hauptversion landen. Das Canonical dient dort als zusätzliches Signal.
Ein Sonderfall: Paginierung
Bei Seite 2, 3 und 4 einer Kategorie ist der häufigste Fehler, überall ein Canonical auf Seite 1 zu setzen. Das ist falsch, denn Seite 2 zeigt andere Produkte oder Artikel als Seite 1. Jede Seite der Paginierung bekommt ein Canonical auf sich selbst. Google verwendet übrigens die früher üblichen rel prev und rel next Angaben nicht mehr.
Self Referencing Canonical: Warum eine Seite auf sich selbst verweisen darf
Ein Self Referencing Canonical (selbstreferenzierendes Canonical) zeigt auf die eigene URL. Die Seite sagt also: Ich bin die Hauptversion.
Das wirkt absurd, ist aber eine der besten Absicherungen, die du einbauen kannst. Denn irgendwann hängt jemand einen Parameter an deine URL, ein Newsletter Tool ergänzt einen Zusatz oder ein Scraper kopiert deine Seite samt Quelltext. Ist auf der Originalseite bereits ein Canonical auf die saubere URL gesetzt, wird auch jede später entstandene Variante auf die richtige Version zurückgeführt.
Unsere Empfehlung: Jede indexierbare Seite bekommt ein Self Referencing Canonical. Es ist Best Practice, nicht zwingend, aber es kostet fast nichts und verhindert eine ganze Reihe von Problemen.
Canonical ist keine Weiterleitung
Hier stolpern selbst erfahrene Leute. Das Canonical leitet niemanden irgendwohin. Die Seite mit dem Canonical bleibt für Besucher erreichbar und sichtbar. Es ist nur eine Bitte an Google, eine andere URL zu bevorzugen.
| Canonical | 301 Weiterleitung | |
| Besucher | Bleiben auf der aufgerufenen URL | Landen auf der Ziel URL |
| Alte URL erreichbar | Ja | Nein, sie leitet um |
| Für Google | Starker Hinweis, aber kein Befehl | Sehr starkes Signal |
| Typischer Einsatz | Varianten, die weiter existieren sollen (Filter, Parameter, Druckversion) | Dauerhaft ersetzte oder zusammengelegte URLs |
Die einfache Entscheidungsregel: Soll die alte URL für Menschen nicht mehr existieren, nimm eine 301. Soll sie existieren, aber Google soll eine andere URL bevorzugen, nimm Canonical.
Häufige Canonical Fehler und wie du sie vermeidest
Canonical Fehler sind tückisch, weil die Seite völlig normal aussieht. Hier die Klassiker:
- Canonical zeigt auf die falsche URL. Zum Beispiel auf die Startseite statt auf den Artikel, oft durch ein Template, das überall dasselbe ausspielt. Folge: Google behandelt Hunderte Seiten als Duplikate der Startseite.
- Canonical zeigt auf eine nicht erreichbare Seite. Ziel liefert 404 oder 5xx. Google ignoriert das Canonical dann.
- http statt https. Nach einer HTTPS Umstellung bleibt im Template die alte Adresse stehen.
- Canonical auf eine Weiterleitung. Das Ziel leitet selbst weiter. Das Canonical sollte immer direkt auf die endgültige URL zeigen.
- Mehrere widersprüchliche Canonicals. Das passiert oft, wenn ein SEO Plugin und das Theme jeweils eines ausgeben. Prüfe den Quelltext, nicht das Plugin Menü.
- Canonical auf eine Seite mit noindex. Das Signal lautet gleichzeitig: Nimm diese Seite als Hauptversion, und: Diese Seite soll nicht in den Index. Google weiß dann nicht, was du willst.
- Canonical per JavaScript nachträglich geändert. Das kann funktionieren, ist aber unsicher. Setze es direkt im ausgelieferten HTML.
- Canonical statt echter Lösung. Zwei Seiten mit völlig unterschiedlichem Inhalt per Canonical zusammenzulegen, funktioniert nicht. Google erkennt das und ignoriert das Canonical.
- Relative Pfade und Groß Kleinschreibung. Ein Canonical auf /Artikel/ ist nicht dasselbe wie auf /artikel/.
Kann Google ein Canonical ignorieren?
Ja, das darf es. Ein Canonical ist ein starker Hinweis, aber kein verbindlicher Befehl. Google wertet mehrere Signale zusammen aus. Dazu gehören:
- Weiterleitungen (sehr starkes Signal)
- Das rel canonical Tag (starkes Signal)
- Die Aufnahme in die Sitemap (schwächeres Signal)
- Interne Verlinkung: Auf welche Variante zeigen deine eigenen Links?
- HTTPS statt HTTP und weitere Qualitätsmerkmale der URL
- Inhaltliche Ähnlichkeit der Seiten
Widerspricht sich das alles, entscheidet Google selbst. Das siehst du in der Search Console unter URL Prüfung: Dort stehen die vom Nutzer deklarierte kanonische URL und die von Google ausgewählte kanonische URL nebeneinander. Weichen die beiden ab, hast du ein Signalproblem.
Was du tun kannst, wenn Google dein Canonical ignoriert
- Prüfe, ob die Seiten wirklich nahezu identisch sind. Falls nicht, mache sie entweder eindeutiger oder akzeptiere die Entscheidung.
- Richte interne Links konsequent auf die gewünschte URL aus.
- Sorge dafür, dass die Sitemap nur die bevorzugte URL enthält.
- Entferne widersprüchliche Signale: Weiterleitungen, hreflang Angaben, noindex.
- Gib Google Zeit. Änderungen werden erst nach einem erneuten Crawl wirksam.
Empfehlung: Canonical und hreflang sauber kombinieren
Bei mehrsprachigen Websites bekommt jede Sprachversion ein Canonical auf sich selbst. Ein Canonical von der englischen auf die deutsche Version sagt Google: Die englische Seite ist ein Duplikat der deutschen. Das ist praktisch immer ungewollt. Die Verknüpfung der Sprachversionen übernehmen die hreflang Angaben, nicht das Canonical.
So, das Canonical ist verstanden. Es sagt Google, welche Variante du bevorzugst. Aber was, wenn eine Seite gar nicht im Index auftauchen soll, egal welche Variante? Dann brauchen wir ein anderes Werkzeug: das noindex.
Noindex: Diese Seite soll nicht in den Suchindex
Das Canonical sagt: Zeig bitte diese Variante. Noindex geht einen Schritt weiter und sagt: Zeig diese Seite bitte gar nicht. Es ist das schärfste der vier Werkzeuge im Hinblick auf die Sichtbarkeit, und genau deshalb auch das mit dem größten Schadenspotenzial. Ein einziges vergessenes noindex nach einem Relaunch kann eine ganze Website aus Google verschwinden lassen.
Was bedeutet Noindex?
Noindex ist eine Anweisung an Suchmaschinen, eine Seite nicht in den Suchindex aufzunehmen beziehungsweise sie daraus zu entfernen. Die Seite bleibt für Besucher normal erreichbar, sie taucht nur nicht mehr in den Suchergebnissen auf. Umgesetzt wird noindex per Meta Tag im HTML Head oder per HTTP Header.
Der entscheidende Unterschied zu dem, was viele denken: Noindex verbietet nicht das Crawlen. Im Gegenteil, Google muss die Seite abrufen, um das noindex überhaupt zu sehen. In unserem Bibliotheks Bild: Der Zettel im Buch wirkt nur, wenn der Bibliothekar das Buch aufschlagen darf.
Das Meta Tag sieht so aus:
<meta name=“robots“ content=“noindex“>
Du kannst Anweisungen kombinieren und auch einen bestimmten Crawler ansprechen:
<meta name=“robots“ content=“noindex, nofollow“>
<meta name=“googlebot“ content=“noindex“>
Zur Einordnung: nofollow bedeutet, dass Links auf der Seite nicht als Empfehlung gewertet werden sollen. In den meisten Fällen brauchst du es zusammen mit noindex nicht.
Weitere Robots Anweisungen, die du kennen solltest
Noindex ist nur eine von mehreren Direktiven. Diese begegnen dir im Alltag am häufigsten:
- nosnippet: Google soll keinen Textauszug anzeigen. Das beeinflusst auch, ob Inhalte in KI Übersichten zitiert werden können.
- max snippet: Begrenzt die Länge des Textauszugs, zum Beispiel auf eine bestimmte Zeichenzahl.
- noarchive: Keine zwischengespeicherte Kopie anbieten.
- unavailable_after: Die Seite soll ab einem bestimmten Datum nicht mehr indexiert werden. Praktisch für Aktionen und Veranstaltungen.
- data nosnippet: Ein Attribut für einzelne Textabschnitte, die nicht in Snippets erscheinen sollen.
Noindex über den HTTP Header: X Robots Tag
Nicht jede Datei hat einen HTML Head. Ein PDF, ein Bild oder eine Textdatei kannst du nicht mit einem Meta Tag versehen. Dafür gibt es den X Robots Tag, eine Anweisung, die der Server im HTTP Header mitschickt:
Beim Apache Server setzt du das zum Beispiel so für alle PDFs:
<FilesMatch „\.pdf$“>
Header set X-Robots-Tag „noindex“
</FilesMatch>
Bei Nginx sieht es so aus:
location ~* \.pdf$ {
add_header X-Robots-Tag „noindex“;
}
Der Header ist besonders praktisch, wenn du viele Dateien auf einmal steuern willst, wenn du keinen Zugriff auf den HTML Code hast oder wenn die Seiten automatisch erzeugt werden. Ob der Header tatsächlich ausgeliefert wird, prüfst du mit einem einfachen Befehl:
curl -I https://www.beispiel.de/downloads/handbuch.pdf
In der Antwort muss die Zeile mit X Robots Tag auftauchen. Wichtig: Meta Tag und Header sind gleichwertig. Widersprechen sie sich, gilt im Zweifel die restriktivere Angabe.
Typische Einsatzbereiche für Noindex
Noindex gehört auf Seiten, die für Besucher nützlich, für Suchergebnisse aber wertlos oder störend sind:
- Interne Suchergebnisse: Unendlich viele Kombinationen, kaum Mehrwert für Suchende.
- Login und Kontobereiche: Niemand sucht bei Google nach deiner Anmeldeseite.
- Danke Seiten: Nach dem Kaufabschluss oder der Newsletter Anmeldung. Sie in Google zu finden, verfälscht außerdem deine Conversion Messung.
- Testseiten und Staging Inhalte: Wobei hier ein Passwortschutz die eigentlich richtige Lösung ist.
- Bestimmte Archivseiten: Autoren, Tag und Datumsarchive, die nur Duplikate von Beiträgen aufzählen.
- Dünne Inhalte: Seiten mit sehr wenig eigenem Inhalt, die du aus nachvollziehbaren Gründen behalten, aber nicht ranken lassen willst.
- Temporäre Inhalte: Aktionsseiten, die ablaufen (mit unavailable_after).
- Interne Dokumente als PDF: Per X Robots Tag.
Ebenso wichtig ist die Gegenseite: Setze noindex nicht auf Seiten, die ranken sollen. Das klingt banal, aber Plugins und Theme Einstellungen, die noindex für Kategorien, Tags oder ganze Beitragstypen setzen, sind eine ergiebige Fehlerquelle.
Noindex ist kein Delete
Noindex löscht nichts. Die Seite bleibt erreichbar, die URL bleibt Google bekannt, und Google wird sie weiter gelegentlich abrufen, um zu prüfen, ob das noindex noch da ist. Der Unterschied zwischen aus dem Index entfernen und löschen ist wichtig:
| Ziel | Richtige Maßnahme |
| Seite soll erreichbar bleiben, aber nicht in Google erscheinen | Noindex |
| Seite existiert nicht mehr | Statuscode 404 oder 410 |
| Seite wurde durch eine andere ersetzt | 301 Weiterleitung auf die neue URL |
| Inhalt ist vertraulich | Passwortschutz oder Login (Statuscode 401 oder 403) |
| Seite muss in Google sofort verschwinden | Antrag in der Search Console auf vorübergehende Entfernung, zusätzlich eine dauerhafte Maßnahme aus dieser Tabelle |
Der Antrag auf Entfernung in der Search Console ist nur eine temporäre Verdeckung für etwa ein halbes Jahr. Ohne zusätzliche dauerhafte Maßnahme kann die URL danach zurückkehren.
Und noch etwas zur Dauer: Noindex wirkt erst, wenn Google die Seite erneut gecrawlt hat. Bei selten besuchten Seiten kann das Tage bis Wochen dauern. Das ist kein Fehler, das ist normal.
Ein Hinweis zu der Kombination noindex, follow: Google hat erklärt, dass es Links auf dauerhaft noindex gesetzten Seiten langfristig wie nofollow behandeln kann. Verlasse dich also nicht darauf, dass Linkkraft über eine noindex Seite weiterfließt.
Noindex und Canonical kombinieren?
Die Kurzantwort: Meistens nicht, und wenn, dann sehr bewusst.
- Noindex mit Self Referencing Canonical: unproblematisch. Die Seite sagt: Ich bin die Hauptversion meiner selbst, aber bitte nicht indexieren. Das passt zusammen.
- Noindex mit Canonical auf eine andere URL: widersprüchlich. Das Canonical sagt: Die andere Seite ist die Hauptversion, das noindex sagt: Nimm diese Seite nicht auf. Welches Signal Google bevorzugt, ist nicht vorhersehbar.
- Canonical auf eine Seite, die selbst noindex hat: der Klassiker unter den Fehlkonfigurationen. Du leitest alle Signale auf eine Seite, die gar nicht im Index sein darf.
Google empfiehlt ausdrücklich, noindex nicht zu verwenden, um innerhalb einer Website die Auswahl einer kanonischen Seite zu steuern, weil dadurch die Seite komplett aus der Suche ausgeschlossen wird. Dafür ist das Canonical da.
Der häufigste Fehler: Noindex und robots.txt gleichzeitig
Jetzt kommen wir zum Stolperstein aus der Einleitung. Eine typische Konfiguration sieht so aus:
User-agent: *
Disallow: /intern/
Und auf den Seiten unter /intern/ steht zusätzlich:
<meta name=“robots“ content=“noindex“>
Das wirkt sicher, ist aber ein Widerspruch. Google darf die Seiten unter /intern/ nicht abrufen, also liest es das noindex nie. Was passiert dann? Ist die URL von irgendwoher verlinkt, kann Google sie trotzdem in den Index nehmen, nur eben ohne Inhalt. Im Suchergebnis erscheint dann ein nackter Link mit dem Hinweis, dass keine Informationen verfügbar sind.
Wichtig: Das noindex in der robots.txt selbst, das früher manchmal verwendet wurde, wird von Google seit dem Jahr 2019 nicht mehr unterstützt. Verlass dich nicht auf alte Anleitungen.
So räumst du das richtig auf
Wenn bereits indexierte Seiten durch robots.txt blockiert sind, gehst du in dieser Reihenfolge vor:
- Entferne die Disallow Regel aus der robots.txt, damit Google die Seiten wieder abrufen darf.
- Setze auf den Seiten noindex (Meta Tag oder X Robots Tag).
- Warte, bis die Search Console zeigt, dass die URLs aus dem Index verschwunden sind.
- Erst jetzt, wenn du Crawling Aufwand sparen willst, darfst du den Bereich wieder per robots.txt sperren.
Trick: Eine temporäre Sitemap, die nur die betroffenen URLs mit aktuellem lastmod Datum enthält, kann Google dazu bringen, sie schneller erneut zu besuchen. Nach der Bereinigung nimmst du die Sitemap wieder heraus.
Empfehlung: Noindex und KI Suchergebnisse
Google KI Übersichten und ähnliche Antwortsysteme greifen auf Inhalte zurück, die im Suchindex stehen und für Snippets zugelassen sind. Eine Seite mit noindex kann dort nicht als Quelle auftauchen. Steuerst du außerdem mit nosnippet oder max snippet, begrenzt du, wie viel von deinem Text verwendet werden darf. Überlege also bewusst: Welche Seiten sollen für Menschen und für KI Antworten sichtbar sein, und welche nicht?
Damit haben wir zwei Werkzeuge: eins für die bevorzugte Variante, eins für den Ausschluss aus dem Index. Beide setzen voraus, dass Google die Seite lesen darf. Und wer das regelt, ist das nächste Thema: die robots.txt.
robots.txt: Was darf der Crawler abrufen?
Die robots.txt ist das älteste der vier Werkzeuge, und gleichzeitig das mit den meisten Mythen. Manche halten sie für einen Sicherheitsschalter, andere für ein SEO Zaubermittel. Beides ist falsch. Sie ist im Kern ein höfliches Schild an der Tür, und zwar eines, an das sich seriöse Crawler halten, böswillige aber nicht.
Was ist robots.txt?
Die robots.txt ist eine einfache Textdatei im Hauptverzeichnis einer Website, in der du Crawlern mitteilst, welche Bereiche sie abrufen dürfen und welche nicht. Sie folgt dem Robots Exclusion Protocol, das inzwischen als offizieller Internetstandard beschrieben ist, und wird von Google, Bing und den meisten seriösen Crawlern beachtet.
Drei Formalien, die oft übersehen werden:
- Speicherort: Immer im Stammverzeichnis der Domain, also unter https://www.beispiel.de/robots.txt. In einem Unterordner wird sie nicht gelesen.
- Gilt pro Host: Jede Subdomain und auch jedes Protokoll hat eine eigene robots.txt. Die Datei von www.beispiel.de gilt nicht für blog.beispiel.de.
- Format: Reiner Text in der Kodierung UTF 8. Google verarbeitet nur die ersten 500 Kilobyte der Datei, alles darüber wird ignoriert.
Ein Minimalbeispiel:
User-agent: *
Disallow: /admin/
Übersetzt: Für alle Crawler (das Sternchen) ist der Ordner /admin/ tabu.
Was die robots.txt tatsächlich macht
Die robots.txt steuert das Crawling. Sie entscheidet, ob ein Crawler eine URL abrufen darf oder nicht. Das ist nützlich, um:
- Bereiche und Ressourcen vom Abruf auszuschließen, etwa Admin Bereiche, Warenkörbe oder interne Suchseiten.
- Crawl Aufwand zu reduzieren, damit Google seine Zeit bei großen Websites nicht mit endlosen Filter Kombinationen verbringt.
- Server zu entlasten, wenn Bots unnötig viele Anfragen verursachen.
Die vier Bausteine, aus denen jede robots.txt besteht:
| Baustein | Bedeutung |
| User-agent | Für welchen Crawler gilt der folgende Block? Das Sternchen steht für alle. |
| Disallow | Dieser Pfad darf nicht abgerufen werden. |
| Allow | Ausnahme von einem Disallow, dieser Pfad darf abgerufen werden. |
| Sitemap | Adresse deiner XML Sitemap. Gilt unabhängig vom User agent. |
Dazu kommen zwei Sonderzeichen für Muster: das Sternchen (beliebige Zeichenfolge) und das Dollarzeichen (Ende der URL). Wie Muster wirken, zeigt diese Übersicht:
| Regel | Wirkung |
| Disallow: / | Sperrt die gesamte Website |
| Disallow: (leer) | Sperrt nichts, alles ist erlaubt |
| Disallow: /admin/ | Sperrt alles unterhalb von /admin/ |
| Disallow: /admin | Sperrt alles, dessen Pfad mit /admin beginnt, auch /administration |
| Disallow: /*.pdf$ | Sperrt alle URLs, die auf .pdf enden |
| Disallow: /*?sortierung= | Sperrt alle URLs mit dem Parameter sortierung |
| Allow: /admin/hilfe/ | Ausnahme: Dieser Unterordner bleibt abrufbar |
Was passiert, wenn sich Regeln überschneiden? Google wendet die spezifischste Regel an, also die mit dem längsten passenden Pfad. Bei Gleichstand gewinnt die weniger restriktive, also Allow. Pfade sind außerdem Groß und Kleinschreibung sensibel: /Admin/ ist nicht /admin/.
Eine Falle bei mehreren User agent Blöcken
Wenn du einen Block für einen bestimmten Crawler anlegst, zum Beispiel für den Googlebot, nutzt dieser Crawler nur noch diesen Block und ignoriert den Block für das Sternchen komplett. Die Regeln werden nicht zusammengefügt. Wer einen Sonderblock für den Googlebot ergänzt, muss deshalb alle gewünschten Regeln dort wiederholen.
Was die robots.txt NICHT macht
Hier trennt sich die Spreu vom Weizen. Dieser Abschnitt ist vielleicht der wichtigste des ganzen Kapitels:
- Sie ist kein Zugriffsschutz. Die Datei ist öffentlich lesbar und listet genau die Pfade auf, die du verstecken willst. Wer wirklich etwas schützen muss, nutzt Passwort, Login oder Serverkonfiguration. Eine Disallow Zeile für /geheim/ ist praktisch ein Wegweiser.
- Sie ist keine Garantie gegen Indexierung. Eine blockierte URL kann trotzdem im Index auftauchen, wenn andere Seiten auf sie verlinken. Google kennt dann die Adresse, aber nicht den Inhalt.
- Sie ist kein Ersatz für Noindex. Wer die Indexierung verhindern will, braucht noindex, und dafür muss die Seite crawlbar sein.
- Sie entfernt keine bereits bekannten URLs. Eine Disallow Regel nimmt nichts aus dem Index.
- Sie verbessert das Ranking nicht an sich. Sie kann höchstens indirekt helfen, wenn Crawl Ressourcen frei werden.
- Sie bindet nicht jeden Bot. Seriöse Crawler halten sich daran, Scraper und Schadsoftware nicht.
Typische robots.txt Regeln für die Praxis
Eine solide Grundkonfiguration für eine normale Website sieht so aus:
User-agent: *
Allow: /
Disallow: /admin/
Disallow: /intern/
Disallow: /warenkorb/
Disallow: /suche/
Disallow: /*?sortierung=
Sitemap: https://www.beispiel.de/sitemap.xml
Bei WordPress ist folgende Variante verbreitet:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://www.beispiel.de/sitemap_index.xml
Beachte: Blockiere keine CSS und JavaScript Dateien, die Google zum Darstellen der Seite braucht. Ohne sie kann Google die Seite nicht richtig rendern und bewerten.
Die Sitemap Zeile in der robots.txt
Mit einer Zeile sagst du jedem Crawler, wo deine Sitemap liegt:
Sitemap: https://www.beispiel.de/sitemap.xml
Die Adresse muss absolut sein, also komplett mit https und Domain. Du kannst mehrere Sitemap Zeilen angeben, etwa für Bilder oder Videos. Die Zeile steht außerhalb der User agent Blöcke und gilt für alle. Das ist einer der einfachsten Wege, eine Sitemap bekannt zu machen, auch für Bing und andere Suchmaschinen, die du vielleicht nicht in deren Tools eingetragen hast.
KI Crawler in der robots.txt: Der Trend des Jahres
Seit KI Assistenten Websites auslesen, wird die robots.txt auch dafür genutzt, bestimmten KI Crawlern den Zugang zu erlauben oder zu verbieten. Bekannte Kennungen sind GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot, CCBot (Common Crawl) und Google Extended. Ein Beispiel:
User-agent: GPTBot
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Google-Extended
Disallow: /
Achtung, hier lauern drei Missverständnisse:
- Google Extended ist kein Ranking Schalter. Es steuert, ob Inhalte für bestimmte generative KI Funktionen von Google verwendet werden dürfen. Es ändert nichts daran, ob deine Seiten in der normalen Suche stehen. Wer den Googlebot blockiert, verschwindet dagegen aus der Suche.
- Die Kennungen ändern sich. Anbieter ergänzen und trennen ihre Crawler, zum Beispiel für Training, für Suche und für Nutzeranfragen. Schau vor dem Eintragen in die aktuelle Dokumentation des jeweiligen Anbieters.
- Es bleibt freiwillig. Auch hier gilt: Seriöse Anbieter halten sich daran, eine technische Garantie ist es nicht.
Die Entscheidung ist ein Abwägen. Sperrst du KI Crawler, schützt du deine Inhalte vor Verwendung für Training und Antworten, verzichtest aber womöglich auf Sichtbarkeit und Erwähnungen in KI Antworten. Lässt du sie zu, gewinnst du Reichweite in neuen Kanälen, gibst aber Kontrolle über die Nutzung ab. Ein pauschales Richtig gibt es nicht, es hängt von deinem Geschäftsmodell ab.
Häufige robots.txt Fehler
Eine falsche robots.txt kann teuer werden. Diese Fehler begegnen uns am häufigsten:
- Die gesamte Website ist versehentlich blockiert. Die Zeile Disallow: / stammt aus der Testumgebung und wanderte beim Livegang mit auf den Server. Ein Klassiker bei Relaunches, der sich im Traffic erst nach einigen Tagen bemerkbar macht.
- CSS und JavaScript sind blockiert. Google sieht eine kaputte Seite und bewertet sie entsprechend.
- Falsche Pfade. Ein fehlender Schrägstrich oder Groß und Kleinschreibung machen die Regel wirkungslos oder zu weit gefasst.
- Wildcards falsch eingesetzt. Disallow: /*? sperrt alle URLs mit einem Fragezeichen, also auch solche, die du eigentlich crawlen lassen wolltest.
- Mehrere widersprüchliche Regeln. Spezifischere Allow Zeilen heben allgemeinere Disallow Zeilen auf, manchmal unbeabsichtigt.
- Alte Regeln aus früheren Websites. Nach einem CMS Wechsel stehen noch Pfade im Dokument, die es längst nicht mehr gibt, oder schlimmer, Pfade, die jetzt wichtige Seiten treffen.
- Ein Noindex in der robots.txt. Wird von Google nicht unterstützt und bleibt wirkungslos.
- Crawl delay Angaben. Google ignoriert diese Anweisung. Bei Bing wirkt sie teilweise, bei Google nicht.
- Falscher Statuscode. Die Datei muss mit 200 ausgeliefert werden. Ein 404 wird von Google so interpretiert, als gäbe es keine Einschränkungen. Bei einem dauerhaften 5xx Fehler pausiert Google vorsichtshalber das Crawling.
- Vergessene Subdomains. Die robots.txt der Hauptdomain gilt nicht für Subdomains.
robots.txt testen
Nach jeder Änderung testest du, bevor du dich zurücklehnst:
- Datei im Browser öffnen. Gib die Adresse deiner robots.txt ein und lies, was der Server tatsächlich ausliefert, nicht was du hochgeladen zu haben glaubst.
- Statuscode prüfen. Mit curl wie in Kapitel 4: Antwort 200 und Inhaltstyp text/plain.
- Search Console nutzen. Unter den Einstellungen findest du den robots.txt Bericht. Er zeigt, welche Version Google zuletzt abgerufen hat und ob Fehler oder Warnungen vorliegen.
- URL Prüfung. In der Search Console gibst du eine konkrete URL ein und siehst, ob das Crawling zulässig ist und welche Regel sie trifft.
- Wichtige URLs gegenprüfen. Teste mindestens Startseite, eine Kategorie, einen Artikel und eine Sitemap Adresse.
Warum ist ein Syntaxfehler so tückisch? Weil Google ungültige Zeilen einfach überspringt, ohne dich zu warnen. Ein Tippfehler wie Dissallow führt dazu, dass die Regel stillschweigend wirkungslos bleibt, und du glaubst, ein Bereich sei gesperrt, obwohl er offen ist.
Damit steht das Gerüst: Wer darf rein (robots.txt), was soll im Katalog stehen (Noindex), welche Variante ist die Hauptausgabe (Canonical). Fehlt noch die Liste am Empfang, die Google sagt, wo es überhaupt hinschauen soll: die Sitemap.
Sitemap: Welche URLs sind wichtig?
Die Sitemap ist das freundlichste der vier Werkzeuge. Sie verbietet nichts, sie schließt nichts aus, sie sagt nur: Hier ist die Liste der Seiten, die mir wichtig sind. Und trotzdem wird sie am häufigsten überschätzt, denn viele glauben, eine Sitemap sei eine Eintrittskarte in den Index. Das ist sie nicht.
Was ist eine XML Sitemap?
Eine XML Sitemap ist eine Datei, die die URLs deiner Website auflistet, die Suchmaschinen kennen und crawlen sollen, optional ergänzt um Angaben wie das Datum der letzten Änderung. Sie hilft bei der Entdeckung von Seiten, ersetzt aber weder gute interne Verlinkung noch eine Indexierungsentscheidung.
So sieht der Aufbau aus:
<?xml version=“1.0″ encoding=“UTF-8″?>
<urlset xmlns=“http://www.sitemaps.org/schemas/sitemap/0.9″>
<url>
<loc>https://www.beispiel.de/artikel/</loc>
<lastmod>2026-10-06</lastmod>
</url>
<url>
<loc>https://www.beispiel.de/ratgeber/</loc>
<lastmod>2026-09-21</lastmod>
</url>
</urlset>
Die Bausteine:
- loc: Die vollständige, absolute URL. Pflicht.
- lastmod: Das Datum der letzten wesentlichen Änderung im Format Jahr Monat Tag. Optional, aber nützlich, wenn es ehrlich gepflegt wird.
- priority und changefreq: Gibt es im Standard, werden von Google aber ignoriert. Du kannst sie weglassen.
Das Datum solltest du nur aktualisieren, wenn sich der Inhalt wirklich geändert hat. Wer jeden Tag bei allen URLs das aktuelle Datum einträgt, trainiert Google dazu, die Angabe zu ignorieren.
Was bringt eine Sitemap?
Drei echte Vorteile:
- Wichtige URLs bekannt machen. Besonders bei neuen Websites mit wenigen eingehenden Links ist die Sitemap ein schneller Weg, Google auf Inhalte aufmerksam zu machen.
- Große Websites strukturieren. Mit mehreren Sitemaps (etwa je Inhaltstyp) siehst du in der Search Console, in welchem Bereich die Indexierung hakt.
- Neue und geänderte Inhalte schneller auffindbar machen. Ein verlässliches lastmod Datum hilft Google bei der Entscheidung, was neu besucht werden soll.
Google sagt selbst, dass eine kleine, gut verlinkte Website nicht zwingend eine Sitemap braucht. Sinnvoll ist sie vor allem bei großen Websites, bei neuen Websites mit wenigen Links, bei Seiten mit vielen Medieninhalten oder bei Nachrichtenangeboten. Schaden tut sie nie, wenn sie sauber ist, und deshalb empfehlen wir sie praktisch immer.
Sitemap ist keine Indexierungsgarantie
Das muss ganz deutlich gesagt werden: Eine URL in der Sitemap ist nicht gleich eine URL im Index. Google bewertet jede Seite trotzdem selbst. Ist der Inhalt dünn, doppelt oder wenig hilfreich, wird er auch mit Sitemap Eintrag nicht aufgenommen.
Ein typisches Szenario: Ein Shop reicht 8.000 Produkte per Sitemap ein, in der Search Console stehen am Ende 3.000 als indexiert. Das heißt nicht, dass die Sitemap kaputt ist, sondern dass Google 5.000 URLs aus Qualitäts oder Duplikatsgründen nicht aufnehmen wollte. Die Sitemap hat ihre Arbeit getan (Entdeckung), der Rest liegt an Inhalt und Signalen.
Welche URLs gehören in die Sitemap?
Die Faustregel: nur URLs, die du in Google sehen willst. Das heißt konkret:
- Kanonische URLs: Jeweils die bevorzugte Version, keine Varianten.
- Indexierbare Seiten: Statuscode 200, kein noindex.
- Wichtige Inhalte: Artikel, Produkte, Kategorien mit Mehrwert, Ratgeber, Tools.
Welche URLs gehören nicht hinein?
Hier macht fast jede gewachsene Website Fehler. Diese Adressen haben in der Sitemap nichts verloren:
- Noindex Seiten: Du bittest Google, sie nicht aufzunehmen, und lädst gleichzeitig dazu ein. Das ist ein Widerspruch.
- Weiterleitungen (301, 302): Liste das Ziel, nicht die alte Adresse.
- Fehlerseiten (404, 410): Tote URLs verschwenden Crawl Aufwand und lassen die Datei unseriös wirken.
- Durch robots.txt blockierte URLs: Du lädst ein und sperrst gleichzeitig die Tür.
- Doppelte URLs: Alle Varianten außer der kanonischen.
- Irrelevante Parameter URLs: Tracking, Sortierung, Sitzungen.
Je sauberer die Sitemap, desto mehr Vertrauen kann Google in sie setzen. Sie ist wie eine Empfehlungsliste: Steht dort ständig Unsinn drauf, liest bald niemand mehr hin.
Sitemap Arten im Überblick
| Art | Wofür | Hinweis |
| XML Sitemap | Normale Seiten | Der Standard für fast jede Website |
| Sitemap Index | Verwaltet mehrere Sitemaps | Pflicht ab dem Erreichen der Größenlimits, sonst praktisch zur Strukturierung |
| Bild Sitemap | Bilder zu Seiten ergänzen | Hilfreich, wenn Bilder per JavaScript geladen werden |
| Video Sitemap | Videos mit Titel, Beschreibung, Vorschaubild | Verbessert die Auffindbarkeit in der Videosuche |
| News Sitemap | Aktuelle Nachrichtenartikel | Nur für Artikel der letzten zwei Tage, höchstens 1.000 URLs |
Bei mehrsprachigen Websites können in der Sitemap auch hreflang Beziehungen zwischen den Sprachversionen hinterlegt werden. Das ist eine Alternative zu den Angaben im HTML Head.
Wie groß darf eine Sitemap sein?
Eine einzelne Sitemap darf höchstens 50.000 URLs enthalten und unkomprimiert nicht größer als 50 Megabyte sein. Brauchst du mehr, teilst du auf mehrere Dateien auf und fasst sie in einem Sitemap Index zusammen, der selbst wieder bis zu 50.000 Sitemaps enthalten darf.
<?xml version=“1.0″ encoding=“UTF-8″?>
<sitemapindex xmlns=“http://www.sitemaps.org/schemas/sitemap/0.9″>
<sitemap>
<loc>https://www.beispiel.de/sitemap-artikel.xml</loc>
<lastmod>2026-10-06</lastmod>
</sitemap>
<sitemap>
<loc>https://www.beispiel.de/sitemap-kategorien.xml</loc>
<lastmod>2026-09-30</lastmod>
</sitemap>
</sitemapindex>
Sitemap einreichen und aktuell halten
Du hast zwei Wege, die sich ergänzen:
- robots.txt: Die Zeile Sitemap mit der absoluten Adresse (siehe Kapitel 5).
- Search Console: Unter Sitemaps trägst du die Adresse ein. Dort siehst du danach, wie viele URLs entdeckt wurden und ob Fehler aufgetreten sind.
Der früher übliche Ping Aufruf, mit dem man Google über eine neue Sitemap informieren konnte, wird nicht mehr unterstützt. Verlass dich auf die beiden Wege oben und auf ein ehrliches lastmod Datum. Bing und einige andere Suchmaschinen unterstützen außerdem das Protokoll IndexNow, mit dem du Änderungen aktiv melden kannst. Google nutzt es bisher nicht.
Noch ein Detail: Eine Sitemap darf nur URLs ihrer eigenen Domain enthalten, und der Speicherort bestimmt, was sie abdecken darf. Die sicherste Position ist das Stammverzeichnis.
Empfehlung: Mehrere Sitemaps als Diagnosewerkzeug
Teile deine Sitemap bewusst nach Inhaltstyp auf, zum Beispiel Artikel, Kategorien, Produkte, Tools. Die Search Console zeigt dir den Indexierungsstatus pro eingereichter Sitemap. So erkennst du auf einen Blick, dass 95 Prozent deiner Artikel indexiert sind, aber nur 40 Prozent der Produkte. Das ist wertvoller als jede Gesamtzahl.
Jetzt kennen wir alle vier Spieler einzeln. Doch ein Team wird erst dann daraus, wenn man sie nebeneinanderstellt. Das machen wir jetzt.
Der direkte Vergleich: Vier Werkzeuge nebeneinander
Jetzt bringen wir alles auf einen Nenner. Diese Tabelle ist der Spickzettel, den du dir ausdrucken oder als Lesezeichen speichern darfst:
| Werkzeug | Hauptaufgabe | Wirkt auf Crawling | Wirkt auf Indexierung | Wirkt auf Ranking | Wo steht es |
| Canonical | Bevorzugte URL bestimmen | Nein | Ja, beeinflusst die Auswahl der indexierten URL | Indirekt, durch gebündelte Signale | HTML Head oder HTTP Header |
| Noindex | URL aus dem Index heraushalten | Nein, setzt Crawling sogar voraus | Ja, direkt | Indirekt | Meta Tag oder X Robots Tag |
| robots.txt | Crawling steuern | Ja, direkt | Nein | Nein | Datei im Stammverzeichnis |
| Sitemap | URLs bekannt machen | Unterstützt die Entdeckung | Nein | Nein | XML Datei, bekannt gemacht per robots.txt oder Search Console |
Wenn du die Tabelle von links nach rechts liest, siehst du das Muster: Jede Zeile hat genau einen Schwerpunkt, und keine Zeile deckt zwei Aufgaben ab.
Die vier Merksätze
Wenn du dir nur vier Sätze merkst, dann diese:
robots.txt sagt: Bitte diese URL nicht abrufen.
Noindex sagt: Bitte diese URL nicht in den Index aufnehmen.
Canonical sagt: Diese URL ist die bevorzugte Version.
Sitemap sagt: Diese URLs sind für meine Website wichtig.
Das Schöne an diesen Sätzen: Du kannst jede Situation daran prüfen. Willst du, dass Google etwas nicht liest? Erster Satz. Willst du, dass es gelesen, aber nicht gezeigt wird? Zweiter Satz. Gibt es mehrere gleiche Seiten? Dritter Satz. Soll Google Seiten kennenlernen? Vierter Satz.
Die schnelle Entscheidungshilfe
So findest du in zehn Sekunden das passende Werkzeug:
| Deine Situation | Dein Werkzeug |
| Mehrere URLs zeigen denselben Inhalt und sollen alle erreichbar bleiben | Canonical |
| Eine Seite soll erreichbar sein, aber nicht in Google erscheinen | Noindex |
| Ein Bereich soll gar nicht erst abgerufen werden, etwa Filterkombinationen | robots.txt |
| Neue Inhalte sollen Google schneller auffallen | Sitemap und interne Links |
| Eine alte URL wurde dauerhaft ersetzt | 301 Weiterleitung, dazu Canonical und Sitemap aktualisieren |
| Eine Seite existiert nicht mehr | Statuscode 404 oder 410 |
| Inhalt soll wirklich privat sein | Passwortschutz oder Login, nichts davon |
Die letzte Zeile ist kein Scherz. Alle vier Werkzeuge sind Hinweise an Suchmaschinen, kein Schutz vor Menschen oder bösartigen Bots.
Was die Werkzeuge gemeinsam haben, und was nicht
- Gemeinsam: Alle vier sind Signale. Google nimmt sie ernst, ist aber nicht verpflichtet, jedem blind zu folgen, mit Ausnahme der Crawling Sperre in der robots.txt und eines gelesenen noindex, die in der Praxis sehr zuverlässig befolgt werden.
- Verschieden: Sie greifen an unterschiedlichen Stellen ein (Entdeckung, Crawling, Indexierung) und haben unterschiedliche Voraussetzungen. Noindex braucht Crawling, Canonical braucht eine erreichbare Zielseite, die Sitemap braucht saubere URLs.
Diese Abhängigkeiten sind der Schlüssel zum nächsten Kapitel, denn dort zeigen wir, wie die vier Werkzeuge im echten Betrieb zusammenarbeiten.
Die vier Werkzeuge zusammenspielen lassen: Sechs Szenarien aus der Praxis
Theorie ist schön, aber am Ende zählt, was du an einem Dienstagnachmittag in deine Konfiguration schreibst. Deshalb gehen wir sechs Alltagssituationen durch. Zu jeder bekommst du die Einstellung, die Begründung und die typische Stolperfalle.
Szenario 1: Die normale Artikelseite
Deine Seite soll ranken, ganz normal.
- Canonical: Ja, auf sich selbst (Self Referencing)
- Sitemap: Ja, mit ehrlichem lastmod Datum
- Noindex: Nein
- robots.txt: Nicht blockiert
Warum: Nichts darf der Seite im Weg stehen. Das Canonical sichert sie gegen künftige Parameter Varianten ab, die Sitemap macht sie bekannt.
Stolperfalle: Ein Plugin setzt noindex auf einen ganzen Beitragstyp, ohne dass du es merkst. Prüfe nach jedem Update oder Theme Wechsel stichprobenartig den Quelltext.
Szenario 2: Interne Suchergebnisse
Deine Website hat eine Suchfunktion, und URLs wie /suche/?q=canonical entstehen endlos.
- Noindex: Ja, auf der Suchergebnisseite
- Sitemap: Nein, gehört nicht hinein
- robots.txt: Nicht zwingend, später optional
- Canonical: Nicht nötig, die Seite soll gar nicht in den Index
Warum: Suchergebnisse sind für Google Duplikate und Endlosschleifen, für Nutzer aber kein sinnvoller Einstieg aus der Suche. Noindex lässt Google die Seite sehen und aussortieren.
Stolperfalle: Du sperrst /suche/ per robots.txt, solange noch Suchseiten im Index stehen. Dann kann Google das noindex nicht lesen, und die Seiten bleiben. Richtige Reihenfolge: erst noindex, warten bis alles draußen ist, dann optional sperren. Bei Websites mit enormem Crawl Aufwand durch die Suche ist die Sperre der zweite Schritt, nicht der erste.
Szenario 3: URL mit Tracking Parameter
Dein Newsletter verlinkt auf /artikel/?utm_source=newsletter.
- Canonical: Auf die saubere URL /artikel/
- Sitemap: Enthält nur die saubere URL
- Noindex und robots.txt: Nicht nötig
Warum: Die Parameter URL soll für Besucher normal funktionieren, damit deine Auswertung läuft. Google bündelt alle Signale auf der sauberen Variante.
<!– Auf /artikel/?utm_source=newsletter –>
<link rel=“canonical“ href=“https://www.beispiel.de/artikel/“>
Stolperfalle: Das Canonical wird dynamisch aus der aktuellen URL erzeugt, inklusive Parameter. Dann zeigt jede Variante auf sich selbst, und das Canonical ist wirkungslos. Es muss fest auf die saubere Adresse zeigen.
Szenario 4: Eine alte URL wurde dauerhaft ersetzt
Du hast einen Artikel überarbeitet und die Adresse geändert, von /seo-tipps/ nach /seo-guide/.
- 301: Von der alten auf die neue URL, direkt und ohne Zwischenschritte
- Canonical: Self Referencing auf der neuen Seite
- Sitemap: Nur die neue URL, die alte raus
- Interne Links: Auf die neue URL aktualisieren
Warum: Die 301 überträgt Besucher und Signale, Canonical und Sitemap bestätigen die Entscheidung. Alle Signale zeigen in dieselbe Richtung, und das mag Google.
Stolperfalle: Weiterleitungsketten. Alt leitet auf Zwischen, Zwischen leitet auf Neu. Jede Station kostet Zeit und Signalstärke. Leite immer direkt auf das Ziel.
Szenario 5: Ein Bereich soll nicht gecrawlt werden
Dein Shop erzeugt durch Filter Kombinationen (Farbe, Größe, Marke, Preis) Hunderttausende URL Varianten, die niemand je in Google finden würde.
- robots.txt: Disallow für die Filter Parameter
- Sitemap: Nur die Hauptkategorien, keine Filterseiten
- Canonical: Für Filter, die ausnahmsweise crawlbar bleiben, auf die Kategorie
User-agent: *
Disallow: /*?farbe=
Disallow: /*?groesse=
Disallow: /*?preis=
Warum: Hier geht es nicht um Indexierung, sondern um Crawl Aufwand. Googles Zeit soll in Produkte fließen, nicht in Kombinatorik.
Stolperfalle: Filter Seiten mit echtem Suchvolumen, etwa Damen Laufschuhe in Größe 40, sperrst du besser nicht. Solche Seiten bekommen eine eigene, saubere URL und ein Self Referencing Canonical.
Szenario 6: Erreichbar, aber nicht im Index
Eine Seite muss für Besucher erreichbar bleiben, soll aber in Google nicht auftauchen, zum Beispiel eine Rabatt Landingpage nur für Newsletter Leser.
- Noindex: Ja
- robots.txt: Auf keinen Fall blockieren
- Sitemap: Nicht aufnehmen
- Canonical: Self Referencing ist okay
Warum: Genau hier passiert der Klassiker: Wer zusätzlich sperrt, macht das noindex unlesbar.
Stolperfalle: Die Seite ist intern verlinkt und kommt dadurch trotzdem in den Index, weil das noindex fehlt oder wegen der Sperre nicht gesehen wird. Verlass dich nie auf Nicht Verlinken allein.
Alle sechs Szenarien in einer Tabelle
| Szenario | Canonical | Noindex | robots.txt | Sitemap | 301 |
| Normale Artikelseite | Auf sich selbst | Nein | Nicht sperren | Ja | Nein |
| Interne Suche | Nicht nötig | Ja | Optional, erst danach | Nein | Nein |
| Tracking Parameter | Auf saubere URL | Nein | Nicht nötig | Nur saubere URL | Nein |
| Alte URL ersetzt | Auf der neuen Seite | Nein | Nicht nötig | Nur neue URL | Ja |
| Bereich nicht crawlen | Falls nötig auf Kategorie | Nein | Ja | Nein | Nein |
| Erreichbar, nicht im Index | Auf sich selbst | Ja | Nicht sperren | Nein | Nein |
Wenn du so denkst, bist du auf dem richtigen Weg: Welches Problem habe ich, und welches Werkzeug löst genau dieses Problem? Genau das gelingt in der Praxis aber oft nicht, und deshalb schauen wir uns jetzt die Fehler an, die wirklich dauernd passieren.
Typische SEO Fehler aus der Praxis: Zehn Irrtümer, die dich Sichtbarkeit kosten
Jetzt wird es ehrlich. Die folgenden zehn Fehler begegnen einem bei Website Prüfungen immer wieder, und zwar nicht bei Anfängern allein. Gerade erfahrene Teams stolpern darüber, weil Websites wachsen, Plugins sich ändern und Wissen verloren geht. Zu jedem Fehler gibt es den Irrglauben, den Grund, warum er nicht stimmt, und wie du ihn findest.
Fehler 1: Noindex setzen und die URL gleichzeitig in der robots.txt blockieren
Der Irrglaube: Doppelt gesichert ist sicher.
Die Realität: Google darf die Seite nicht abrufen und sieht das noindex nie. Die URL kann im Index bleiben, nackt und ohne Inhalt.
So erkennst du es: In der Search Console steht Indexiert, obwohl durch robots.txt blockiert. Die Lösung: Sperre aufheben, noindex setzen, warten, dann optional wieder sperren.
Fehler 2: Alle URLs aus der Sitemap werden automatisch indexiert
Der Irrglaube: Die Sitemap ist eine Aufnahmegarantie.
Die Realität: Sie ist eine Empfehlung zur Entdeckung. Aufgenommen wird nur, was Google für hilfreich und einzigartig hält.
So erkennst du es: In der Search Console liegt die Zahl der indexierten URLs deutlich unter der Zahl der eingereichten. Prüfe dann nicht die Sitemap, sondern die Seiten dahinter.
Fehler 3: Die robots.txt verhindert, dass eine URL bei Google erscheint
Der Irrglaube: Gesperrt heißt unsichtbar.
Die Realität: Die Sperre verhindert nur das Abrufen. Verlinkte URLs können trotzdem im Index landen, nur ohne Beschreibung.
So erkennst du es: Suche in Google nach site:deinedomain.de/bereich und schau, ob Treffer ohne Textauszug auftauchen. Die Lösung: noindex, bei Bedarf auch Passwortschutz.
Fehler 4: Canonical ist dasselbe wie eine 301 Weiterleitung
Der Irrglaube: Beides leitet irgendwie um.
Die Realität: Das Canonical leitet niemanden weiter und ist nur ein Hinweis. Die 301 ist eine tatsächliche, serverseitige Weiterleitung.
So erkennst du es: Rufe die alte URL im Browser auf. Bleibst du dort, ist es ein Canonical. Landest du woanders, ist es eine Weiterleitung.
Fehler 5: Jede URL kommt in die Sitemap
Der Irrglaube: Mehr Einträge, mehr Chancen.
Die Realität: Eine Sitemap voller Weiterleitungen, Fehlerseiten und Duplikate verliert an Aussagekraft. Sie soll deine Auswahl der besten URLs zeigen.
So erkennst du es: Exportiere die Sitemap und prüfe sie mit einem Crawler auf Statuscodes. Alles, was nicht 200 ist, fliegt raus.
Fehler 6: Jede Seite braucht noindex oder Canonical
Der Irrglaube: Je mehr Anweisungen, desto besser.
Die Realität: Eine normale Seite, die ranken soll, braucht kein noindex und nur ein Self Referencing Canonical. Zusätzliche Anweisungen sind Fehlerquellen, keine Verstärker.
So erkennst du es: Prüfe pro Seitentyp den Quelltext. Weniger ist hier mehr.
Fehler 7: Die Sitemap muss möglichst viele URLs enthalten
Der Irrglaube: Eine große Zahl wirkt autoritär.
Die Realität: Google bewertet Qualität, nicht Menge. Fünfzig starke URLs in einer sauberen Sitemap sind besser als fünftausend gemischte.
So erkennst du es: Vergleiche die Zahl der Sitemap URLs mit der Zahl der Seiten, die tatsächlich Traffic bringen sollen.
Fehler 8: Google muss meine Canonical Angabe akzeptieren
Der Irrglaube: Ein Canonical ist ein Befehl.
Die Realität: Es ist ein starker Hinweis. Widersprechen andere Signale, etwa interne Links oder Weiterleitungen, entscheidet Google selbst.
So erkennst du es: In der URL Prüfung der Search Console vergleichst du die vom Nutzer deklarierte mit der von Google gewählten kanonischen URL.
Fehler 9: Canonical auf eine URL, die selbst noindex besitzt
Der Irrglaube: Das Canonical zeigt halt irgendwohin.
Die Realität: Du bündelst Signale auf eine Seite, die nicht im Index sein darf. Das Ergebnis ist unvorhersehbar und im schlimmsten Fall verschwinden beide Varianten.
So erkennst du es: Crawle die Website und lasse prüfen, ob Canonical Ziele noindex oder einen Nicht 200 Statuscode haben.
Fehler 10: Die Sitemap enthält 404, 301 oder doppelte URLs
Der Irrglaube: Das fällt schon nicht auf.
Die Realität: Es fällt auf. In der Search Console häufen sich Hinweise, und Google schenkt der Datei weniger Vertrauen. Außerdem sind es verbrannte Crawls.
So erkennst du es: Der Bericht Sitemaps in der Search Console zeigt Fehler und Warnungen. Dazu gehört ein regelmäßiger Crawl der Sitemap URLs.
Was alle zehn Fehler gemeinsam haben
Schau noch einmal auf die Liste. Es steckt fast immer derselbe Kern dahinter: Jemand hat ein Werkzeug für etwas benutzt, wofür es nicht gedacht ist, oder zwei Werkzeuge widersprechen sich. Genau deshalb haben wir den ganzen Guide um die Frage gebaut, welches Werkzeug welches Problem löst.
Ein letzter Rat zu dem Thema: Fehler treten meist nach Veränderungen auf. Theme Wechsel, Relaunch, Plugin Update, Serverumzug, neues CMS. Wenn du nach jeder dieser Veränderungen fünf Minuten für einen Check einplanst (dazu gibt es in Kapitel 11 und 12 die passende Liste), erwischst du die meisten Probleme, bevor Google sie erwischt.
Und jetzt setzen wir alles zusammen: In einem größeren Praxisbeispiel konfigurieren wir eine komplette Website von Grund auf.
Praxisbeispiel: Eine komplette Website richtig konfigurieren
Definitionen sind gut, ein durchgespielter Fall ist besser. Wir nehmen deshalb eine erfundene, aber realistische Website und konfigurieren sie von vorne bis hinten. Nenne sie Gartenwissen, erreichbar unter www.beispiel.de. Sie besteht aus:
- 500 Ratgeberartikeln
- 50 Kategorien, teils mit mehreren Seiten (Paginierung)
- einer internen Suche
- Filterseiten in den Kategorien (Farbe, Preis, Sortierung)
- 40 PDF Downloads, davon 30 Kopien von Artikeln und 10 eigenständige Checklisten
- alten URLs aus einem früheren Blog Bereich
- Tracking Parametern aus Newsletter und Social Media
- einer Danke Seite und einer Login Seite
Bevor wir eine Zeile Code schreiben, stellen wir uns pro URL Typ die entscheidende Frage: Soll diese URL in Google erscheinen?
Schritt 1: Die Entscheidungstabelle
| URL Typ | Beispiel | Im Index? | Maßnahme | Warum |
| Ratgeberartikel | /ratgeber/rasenmaehen/ | Ja | Self Canonical, in der Sitemap | Kerninhalt, soll ranken |
| Kategorie Seite 1 | /kategorie/rasen/ | Ja | Self Canonical, in der Sitemap | Bündelt Themen, hat eigenen Suchbedarf |
| Kategorie Seite 2 und weiter | /kategorie/rasen/seite/2/ | Ja, aber nachrangig | Self Canonical, nicht in der Sitemap | Zeigt andere Artikel, darf nicht auf Seite 1 zeigen |
| Filter und Sortierung | /kategorie/rasen/?preis=20 | Nein | robots.txt Sperre | Unendliche Kombinationen, kein Suchbedarf |
| Interne Suche | /suche/?q=moos | Nein | Noindex | Endlose Varianten ohne Mehrwert |
| Tracking Varianten | /ratgeber/rasenmaehen/?utm_source=newsletter | Nein | Canonical auf die saubere URL | Soll für Besucher funktionieren |
| PDF Kopien der Artikel | /downloads/kopien/rasen.pdf | Nein | X Robots Tag noindex | Duplikat des Artikels |
| Eigenständige Checklisten PDF | /downloads/checkliste_rasen.pdf | Ja | In der PDF Sitemap | Eigener Mehrwert |
| Alte Blog URLs | /blog/rasenmaehen/ | Nein | 301 auf /ratgeber/rasenmaehen/ | Dauerhaft umgezogen |
| Danke und Login Seite | /danke/, /login/ | Nein | Noindex | Kein Suchbedarf |
Diese Tabelle ist das Herzstück. Sobald sie steht, ist die Umsetzung fast mechanisch.
Schritt 2: Die robots.txt
Wir sperren nur das, was nie in Google erscheinen und auch nicht gecrawlt werden soll: die Filter und Sortierungen. Alles, was ein noindex tragen soll (Suche, Danke, Login), bleibt bewusst offen, damit Google das noindex lesen kann.
User-agent: *
Allow: /
Disallow: /*?farbe=
Disallow: /*?preis=
Disallow: /*?sortierung=
Sitemap: https://www.beispiel.de/sitemap_index.xml
Warum so wenig? Weil jede zusätzliche Sperre eine mögliche Fehlerquelle ist. Und weil die robots.txt keine Aufgabe übernehmen soll, die ein Noindex besser erledigt.
Schritt 3: Die Sitemaps
Wir teilen nach Inhaltstyp auf, damit die Search Console später aussagekräftig ist:
<?xml version=“1.0″ encoding=“UTF-8″?>
<sitemapindex xmlns=“http://www.sitemaps.org/schemas/sitemap/0.9″>
<sitemap>
<loc>https://www.beispiel.de/sitemap_artikel.xml</loc>
</sitemap>
<sitemap>
<loc>https://www.beispiel.de/sitemap_kategorien.xml</loc>
</sitemap>
<sitemap>
<loc>https://www.beispiel.de/sitemap_downloads.xml</loc>
</sitemap>
</sitemapindex>
Inhalt der drei Dateien:
- sitemap_artikel.xml: 500 URLs, alle Ratgeberartikel mit ehrlichem lastmod
- sitemap_kategorien.xml: 50 URLs, nur Seite 1 jeder Kategorie
- sitemap_downloads.xml: 10 URLs, nur die eigenständigen Checklisten
In Summe 560 URLs. Nicht enthalten sind Filter, Suche, Tracking Varianten, Paginierungsseiten, Kopien, alte Blog URLs, Danke und Login.
Schritt 4: Canonical in den Templates
Jeder Artikel bekommt ein fest codiertes, selbstreferenzierendes Canonical. Es wird aus dem Pfad des Artikels gebaut, nicht aus der aufgerufenen URL samt Parametern:
<link rel=“canonical“ href=“https://www.beispiel.de/ratgeber/rasenmaehen/“>
Das gilt auch für Kategorie Seiten. Seite 2 der Kategorie Rasen verweist auf Seite 2, nicht auf Seite 1:
<link rel=“canonical“ href=“https://www.beispiel.de/kategorie/rasen/seite/2/“>
Die Tracking Varianten mit utm Parametern zeigen damit automatisch auf die saubere Adresse, weil das Canonical aus dem Pfad entsteht und Parameter bewusst ausblendet.
Schritt 5: Noindex dort, wo es hingehört
Suche, Danke Seite und Login Seite bekommen im Head das Meta Tag:
<meta name=“robots“ content=“noindex“>
Die 30 PDF Kopien liegen in einem eigenen Ordner, und für diesen Ordner setzen wir den Header. Beim Apache Server in der Datei .htaccess im Ordner downloads/kopien:
<IfModule mod_headers.c>
Header set X-Robots-Tag „noindex“
</IfModule>
Ein Ordner für Kopien ist ein einfacher Trick: Eine einzige Regel erledigt 30 Dateien, und neue Kopien erben sie automatisch.
Schritt 6: Die Weiterleitungen
Die alten Blog URLs bekommen eine dauerhafte 301 auf das neue Schema. Beim Apache Server mit einer Regel für den ganzen Bereich:
RewriteEngine On
RewriteRule ^blog/(.*)$ /ratgeber/$1 [R=301,L]
Prüfe unbedingt, dass es keine Ketten gibt. Wenn zusätzlich von http auf https und von ohne www auf www umgeleitet wird, müssen diese Regeln so gebaut sein, dass ein Besucher mit einer einzigen Weiterleitung beim Ziel landet.
Schritt 7: Das Zusammenspiel prüfen
Jetzt kommt die Stunde der Wahrheit. Diese Fragen sollten alle mit Ja beantwortet werden:
- Stehen alle 560 Sitemap URLs auf Status 200, ohne noindex und mit einem Canonical auf sich selbst?
- Zeigen alle Canonical Angaben auf eine URL mit Status 200?
- Sind die Noindex Seiten (Suche, Danke, Login, PDF Kopien) nicht in der robots.txt gesperrt?
- Fehlen die Filter Varianten in der Sitemap, und sind sie per robots.txt gesperrt?
- Landet jede alte Blog URL mit genau einer Weiterleitung auf der neuen Artikel URL?
Gelingt das, hast du eine Konfiguration, in der alle vier Werkzeuge sich ergänzen, statt gegeneinander zu arbeiten. Das ist das Ziel: keine Widersprüche, keine Überraschungen.
Was wir aus dem Beispiel lernen
- Zuerst die Entscheidung, dann die Technik. Die Tabelle aus Schritt 1 spart dir stundenlanges Herumprobieren.
- Ein Werkzeug pro Aufgabe. Filter werden gesperrt, Suche wird auf noindex gestellt, Varianten bekommen Canonical, alte URLs eine 301.
- Die Sitemap spiegelt deine Entscheidung wider. Sie enthält exakt die URLs, die laut Tabelle im Index sein sollen.
Mit dieser Logik kannst du jede Website konfigurieren, egal wie groß. Damit du dabei nichts vergisst, gibt es im nächsten Kapitel die Checkliste.
Checkliste: Canonical, Noindex, robots.txt und Sitemap
Hier ist die Checkliste zum Abhaken. Du kannst die Kästchen direkt im Dokument anklicken, und zwar bei jedem Projekt neu. Sie funktioniert für eine neue Website genauso wie für den Check nach einem Relaunch.
Canonical
- ☐ Das Canonical verwendet die HTTPS Adresse
- ☐ Es zeigt auf die richtige Hauptdomain (mit oder ohne www, konsequent)
- ☐ Es gibt pro Seite genau eine bevorzugte URL und nur ein Canonical Tag
- ☐ Das Ziel liefert Status 200, keine Weiterleitung und keinen Fehler
- ☐ Das Ziel hat selbst kein noindex
- ☐ Das Canonical steht im Head, nicht im Body
- ☐ Paginierungsseiten verweisen auf sich selbst, nicht auf Seite 1
- ☐ Sprachversionen verweisen jeweils auf sich selbst
- ☐ Die URL Schreibweise (Groß und Kleinschreibung, Schrägstrich am Ende) ist einheitlich
Noindex
- ☐ Noindex steht nur dort, wo Indexierung wirklich unerwünscht ist
- ☐ Keine wichtige Seite hat versehentlich noindex, auch nicht über ein Plugin oder Theme
- ☐ Seiten mit noindex sind nicht per robots.txt gesperrt
- ☐ PDFs und andere Dateien sind über den X Robots Tag berücksichtigt
- ☐ Das noindex steht im ausgelieferten HTML oder Header, nicht erst per JavaScript
- ☐ Seiten mit noindex fehlen in der Sitemap
- ☐ Das Staging System ist per Passwort geschützt, nicht nur per noindex
robots.txt
- ☐ Die Datei ist unter /robots.txt erreichbar und liefert Status 200
- ☐ Die Syntax ist korrekt (keine Tippfehler, keine unbekannten Anweisungen)
- ☐ Die Website ist nicht versehentlich komplett gesperrt
- ☐ Wichtige Ressourcen wie CSS und JavaScript sind nicht blockiert
- ☐ Die Sitemap Adresse ist angegeben
- ☐ Jede Subdomain hat bei Bedarf ihre eigene robots.txt
- ☐ Entscheidungen zu KI Crawlern sind bewusst getroffen und dokumentiert
- ☐ Alte Regeln aus früheren Websites wurden entfernt
Sitemap
- ☐ Sie enthält nur relevante und kanonische URLs
- ☐ Alle URLs liefern Status 200
- ☐ Es gibt keine Weiterleitungen und keine 404 Seiten
- ☐ Es gibt keine noindex URLs und keine per robots.txt gesperrten URLs
- ☐ Das lastmod Datum ist aktuell und ehrlich gepflegt
- ☐ Die Größenlimits (50.000 URLs oder 50 Megabyte) sind eingehalten
- ☐ Die Sitemap ist in der Search Console eingereicht und zeigt keine Fehler
- ☐ Sie ist in der robots.txt referenziert
Der Schnellcheck nach einem Relaunch
Die ersten Stunden nach dem Livegang sind die gefährlichsten. Diese fünf Punkte solltest du sofort prüfen:
- Die robots.txt enthält kein Disallow für die ganze Website.
- Die Startseite und drei Beispielartikel haben kein noindex.
- Das Canonical zeigt auf die Live Domain, nicht auf die Testumgebung.
- Alte URLs leiten per 301 auf die neuen Adressen weiter.
- Die neue Sitemap ist eingereicht, die alte ist entfernt.
Wie oft solltest du prüfen?
| Rhythmus | Was |
| Nach jeder größeren Änderung | Der Schnellcheck nach dem Relaunch |
| Monatlich | Seitenindexierung und Sitemap Berichte in der Search Console ansehen |
| Vierteljährlich | Komplette Checkliste, dazu ein Crawl der gesamten Website |
| Jährlich | Alte Regeln in der robots.txt und Weiterleitungen aufräumen |
Eine Checkliste ist nur so gut wie die Gelegenheit, sie tatsächlich abzuarbeiten. Im nächsten Kapitel zeigen wir dir deshalb Schritt für Schritt, wie du in einer halben Stunde jede Website auf diese Punkte prüfst.
So prüfst du eine Website in 30 Minuten
Wissen ist gut, Nachsehen ist besser. Dieser Ablauf funktioniert für deine eigene Website, für die eines Kunden oder für ein Projekt, das du neu übernimmst. Du brauchst einen Browser, die Search Console und bei Bedarf ein Terminal für einzelne Befehle. Nimm dir eine Tasse Kaffee, es geht los.
Schritt 1: Die robots.txt aufrufen
Öffne im Browser die Adresse deiner Domain mit /robots.txt am Ende. Prüfe drei Dinge: Wird die Datei angezeigt (Status 200)? Steht dort irgendwo ein Disallow mit nur einem Schrägstrich? Ist eine Sitemap Zeile vorhanden?
Wenn die Datei nicht existiert oder nur ein Fehler erscheint, ist das nicht zwingend schlimm, denn Google nimmt dann an, dass nichts gesperrt ist. Aber du verschenkst die Möglichkeit, die Sitemap dort anzugeben.
Schritt 2: Die Sitemap aufrufen
Öffne die in der robots.txt genannte Adresse. Du siehst entweder eine Liste mit URLs oder einen Sitemap Index. Frage dich beim Durchscrollen: Sind das die Seiten, die ich in Google sehen will? Tauchen Adressen mit Parametern, mit /suche/ oder mit alten Pfaden auf? Stimmen die lastmod Daten oder stehen überall das heutige Datum?
Schritt 3: Den HTML Quelltext prüfen
Öffne eine wichtige Seite und rufe den Quelltext auf (Rechtsklick, Seitenquelltext anzeigen, oder die Tastenkombination Strg und U). Suche mit Strg und F nach zwei Begriffen: canonical und robots.
Schritt 4: Das Canonical suchen
Du suchst die Zeile mit rel canonical im Head. Dein Prüfauftrag: Ist die Adresse vollständig und absolut? Stimmt sie mit der aufgerufenen Seite überein, oder zeigt sie bewusst auf eine bevorzugte Version? Gibt es mehr als eine solche Zeile? Wenn ja, hast du ein Problem.
Schritt 5: Noindex prüfen
Suche im Quelltext nach noindex. Findest du ein Meta Tag mit noindex auf einer Seite, die ranken soll, ist Alarm angesagt. Findest du keins, ist das für normale Seiten genau richtig. Für Dateien wie PDFs gilt Schritt 6.
Schritt 6: Den HTTP Header prüfen
Der X Robots Tag steht nicht im Quelltext, sondern im Header der Serverantwort. Die beste Methode ist ein einfacher Befehl im Terminal:
curl -I https://www.beispiel.de/ratgeber/rasenmaehen/
In der Antwort siehst du den Statuscode, den Inhaltstyp und eventuelle Zeilen mit X Robots Tag oder Link rel canonical. Wer kein Terminal nutzen will, findet dieselben Informationen in den Entwicklerwerkzeugen des Browsers im Reiter Netzwerk.
Wer es bequemer mag, kann dafür auch HTTPMAP (httpmap.de) nutzen, ein Dreamcodes Projekt, das sich gerade im Aufbau befindet. Damit siehst du auf einen Blick, welche HTTP Statuscodes, Weiterleitungen und Header deine URL tatsächlich ausliefert, ohne einen Befehl zu tippen. Das ersetzt keine Search Console, ist aber ein schneller Blick hinter die Kulissen einer einzelnen Adresse.
Schritt 7: Sitemap URLs gegen Canonical vergleichen
Jetzt wird es spannend. Alle URLs in der Sitemap sollten auf sich selbst kanonisch sein, Status 200 liefern und kein noindex tragen. Bei kleinen Websites prüfst du Stichproben von Hand. Bei größeren hilft ein Crawler, der eine Sitemap einlesen und Statuscode, Canonical und Indexierbarkeit jeder URL ausgeben kann. Für die schnelle Statusprüfung einer Sitemap reicht auch dieses Kommando im Terminal (nur für eigene Websites, bei großen Listen mit Pausen):
curl -s https://www.beispiel.de/sitemap_artikel.xml | grep -o ‚<loc>[^<]*‘ | sed ’s/<loc>//‘ | while read u; do echo „$(curl -s -o /dev/null -w ‚%{http_code}‘ „$u“) $u“; done
Die Ausgabe zeigt hinter jeder URL den Statuscode. Alles, was nicht 200 ist, gehört geprüft.
Schritt 8: Weiterleitungen prüfen
Mit einem zusätzlichen Schalter folgt curl Weiterleitungen und zeigt jede Station:
curl -sIL http://beispiel.de/blog/rasenmaehen/
Du willst höchstens eine Weiterleitung sehen. Siehst du zwei oder drei Stationen hintereinander, ist das eine Kette, die du zusammenfassen solltest. Prüfe auch, ob alle Varianten (http, https, mit und ohne www) auf eine einzige Version führen.
Schritt 9: Die Search Console kontrollieren
Zum Schluss fragst du Google selbst:
- Seitenindexierung: Welche Ausschlussgründe tauchen auf, und passen sie zu deiner Absicht? Viele Seiten mit noindex bei Seiten, die ranken sollten, wären ein Warnsignal.
- Sitemaps: Wurde die Sitemap gelesen, und wie viele URLs wurden entdeckt?
- robots.txt Bericht: Welche Version hat Google zuletzt abgerufen, und gibt es Warnungen?
- URL Prüfung: Bei verdächtigen Seiten die deklarierte und die von Google gewählte kanonische URL vergleichen.
Wenn du das siehst, tippe auf diese Ursache
| Beobachtung | Wahrscheinliche Ursache | Erster Schritt |
| Wichtige Seite fehlt in Google | Noindex, Sperre oder Canonical auf andere URL | Quelltext und URL Prüfung ansehen |
| Seite erscheint ohne Beschreibung | In robots.txt gesperrt, aber verlinkt | Sperre aufheben, noindex setzen |
| Google wählt eine andere URL als dein Canonical | Widersprüchliche Signale | Interne Links, Sitemap und Weiterleitungen angleichen |
| Viele Seiten im Status Entdeckt, nicht indexiert | Schwache interne Verlinkung, Crawl Budget | Verlinkung stärken, unnötige URLs aussperren |
| Sitemap meldet Fehler | Nicht erreichbare oder gesperrte URLs | Sitemap bereinigen |
Damit hast du die komplette Reihenfolge: robots.txt, Sitemap, Quelltext, Canonical, Noindex, Header, Vergleich, Weiterleitungen, Search Console. Wer das einmal durchgespielt hat, erkennt die meisten Probleme in wenigen Minuten.
Bleiben noch die Fragen, die uns Leserinnen und Leser immer wieder stellen. Die beantworten wir jetzt gebündelt.
FAQ: Die häufigsten Fragen zu Canonical, Noindex, robots.txt und Sitemap
Hier die Fragen, die uns am häufigsten gestellt werden, und die, die Google in den Suchvorschlägen ausspielt. Jede Antwort beginnt mit der Kurzfassung, danach folgt, was du noch wissen solltest.
Was ist der Unterschied zwischen Canonical und Noindex?
Canonical bestimmt, welche von mehreren ähnlichen URLs Google bevorzugt anzeigen soll. Noindex verhindert dagegen, dass eine Seite überhaupt im Index erscheint. Beim Canonical bleibt die Seite im Rennen, nur eine andere Variante ist die Favoritin. Beim Noindex ist sie komplett draußen.
Nutze Canonical für Varianten derselben Seite, Noindex für Seiten ohne Suchwert.
Was ist der Unterschied zwischen robots.txt und Noindex?
Die robots.txt steuert, ob Google eine URL abrufen darf. Noindex steuert, ob eine abgerufene Seite in den Index aufgenommen wird. Das erste verhindert das Lesen, das zweite die Aufnahme. Weil Noindex gelesen werden muss, dürfen beide nicht auf derselben URL gegeneinander arbeiten.
Kann eine robots.txt eine Seite aus Google entfernen?
Nein. Die robots.txt verhindert nur den Abruf, entfernt aber keine bereits bekannte URL aus dem Index. Eine gesperrte URL kann sogar im Index bleiben, wenn andere Seiten auf sie verlinken. Zum Entfernen brauchst du noindex, einen Fehlerstatus (404 oder 410) oder einen Passwortschutz.
Muss jede Website eine Sitemap haben?
Nein, sie ist nicht verpflichtend. Kleine, gut verlinkte Websites werden auch ohne Sitemap gefunden. Sinnvoll ist sie bei großen Websites, neuen Websites mit wenigen Links, Seiten mit vielen Medien und Nachrichtenangeboten. Weil sie fast nichts kostet und beim Diagnostizieren hilft, empfehlen wir sie praktisch immer.
Werden alle URLs aus einer Sitemap indexiert?
Nein. Die Sitemap hilft Google nur, URLs zu entdecken. Ob eine Seite aufgenommen wird, entscheidet Google anhand von Qualität, Einzigartigkeit und technischen Signalen. Auch eine perfekte Sitemap garantiert keine Indexierung.
Kann eine Seite gleichzeitig Canonical und Noindex haben?
Technisch ja, aber nur sinnvoll in einer Konstellation: ein Canonical auf die eigene URL zusammen mit noindex. Ein Canonical auf eine andere URL zusammen mit noindex ist widersprüchlich, und das Ergebnis ist nicht vorhersehbar. Noch schlimmer ist ein Canonical auf eine Seite, die selbst noindex trägt.
Wo gehört der Canonical Tag hin?
In den Head des HTML Dokuments, möglichst weit oben, mit absoluter URL. Im Body wird er ignoriert. Für Dateien ohne HTML, zum Beispiel PDFs, kannst du ihn als Link Angabe im HTTP Header senden.
Kann man PDFs mit Noindex versehen?
Ja, über den X Robots Tag im HTTP Header, denn PDFs haben keinen HTML Head für ein Meta Tag. Die Anweisung wird in der Serverkonfiguration gesetzt, zum Beispiel mit Header set X Robots Tag noindex für alle PDF Dateien oder für einen Ordner. Das PDF darf dabei nicht per robots.txt gesperrt sein.
Wie kann ich eine URL dauerhaft aus Google entfernen?
Setze noindex und lasse die Seite crawlbar, bis sie aus dem Index verschwunden ist. Alternativ liefere den Statuscode 404 oder 410, leite per 301 auf einen Ersatz um oder schütze die Seite per Passwort. Der Antrag auf Entfernung in der Search Console wirkt nur vorübergehend, etwa ein halbes Jahr.
Was passiert, wenn robots.txt und Noindex widersprüchliche Signale liefern?
Die robots.txt gewinnt, und das noindex bleibt unsichtbar. Google darf die Seite nicht abrufen und sieht den Zettel nie. Die URL kann deshalb weiter im Index stehen, meist ohne Beschreibung. Die Lösung: Sperre entfernen, noindex wirken lassen, danach nach Bedarf wieder sperren.
Muss jede Seite in der Sitemap stehen?
Nein. In die Sitemap gehören nur URLs, die indexiert werden sollen: kanonisch, erreichbar und wertvoll. Seiten mit noindex, Weiterleitungen, Fehlerseiten, Duplikate und Filter Varianten lässt du weg. Weniger, aber saubere Einträge sind besser als eine vollgestopfte Liste.
Was passiert, wenn die Sitemap eine falsche URL enthält?
In der Regel passiert nichts Dramatisches, aber es kostet Vertrauen und Crawl Aufwand. Google meldet Fehler im Sitemaps Bericht der Search Console. Fehler 404, Weiterleitungen oder noindex URLs sollten schnell entfernt werden, damit die Datei ihre Glaubwürdigkeit behält.
Wie lange dauert es, bis noindex oder ein Canonical wirkt?
Beides wirkt erst nach dem nächsten Crawl der Seite. Das kann bei oft besuchten Seiten Stunden bis Tage dauern, bei selten besuchten mehrere Wochen. Über die URL Prüfung kannst du in der Search Console eine erneute Prüfung anstoßen, ein Zeitversprechen gibt Google aber nicht.
Canonical oder 301: Was ist besser?
Eine 301 ist besser, wenn die alte URL nicht mehr existieren soll, weil sie Besucher und Signale dauerhaft weiterleitet. Ein Canonical ist besser, wenn mehrere Varianten für Besucher erreichbar bleiben müssen, etwa Parameter oder Druckversionen. Bei Domain Umzügen und Strukturänderungen ist die 301 die erste Wahl.
Ist Noindex ein gutes Mittel gegen Duplicate Content?
Meistens nicht. Gegen Duplikate ist das Canonical oder eine Weiterleitung das passende Werkzeug, denn Noindex nimmt die Seite komplett aus dem Rennen und bündelt keine Signale. Noindex ist dagegen richtig, wenn eine Seite gar nicht in den Suchergebnissen erscheinen soll.
Verbessert eine Sitemap mein Ranking?
Nicht direkt. Sie hilft bei der Entdeckung und beim Verständnis deiner Struktur, aber Ranking hängt von Inhalt, Qualität und Signalen ab. Indirekt kann sie neuen Inhalten helfen, schneller gefunden zu werden.
Soll ich KI Crawler in der robots.txt sperren?
Das hängt von deinem Ziel ab. Eine Sperre schützt Inhalte vor Verwendung für Training und Antworten, kann aber Sichtbarkeit in KI Antworten kosten. Eine Freigabe bringt potenzielle Reichweite, gibt aber Kontrolle ab. Beachte außerdem, dass die robots.txt freiwillig befolgt wird und Kennungen sich ändern. Wer sich für Sperren entscheidet, sollte sie dokumentieren und regelmäßig prüfen.
Beeinflusst robots.txt die Aufnahme in Google KI Übersichten?
Indirekt. Google nutzt für KI Übersichten Inhalte aus dem Suchindex, die für Snippets zugelassen sind. Wer den Googlebot sperrt oder noindex setzt, nimmt Seiten aus dem Spiel. Die Kennung Google Extended betrifft dagegen bestimmte generative Funktionen und ändert nichts an der normalen Suche. Mit nosnippet und max snippet steuerst du, wie viel Text verwendet werden darf.
Wie oft sollte ich meine Sitemap aktualisieren?
Am besten automatisch bei jeder Veröffentlichung oder wesentlichen Änderung. Die meisten CMS Systeme und SEO Plugins erledigen das von allein. Das lastmod Datum sollte nur dann wechseln, wenn sich der Inhalt wirklich verändert hat.
Du hast jetzt alle Antworten. Zeit für das Wesentliche zum Mitnehmen.
Fazit: Vier Werkzeuge, vier Aufgaben
Erinnerst du dich an die beiden Schlösser aus dem Einstieg? Die Sperre in der robots.txt und das noindex auf derselben Seite, die sich gegenseitig aushebeln? Jetzt weißt du nicht nur, warum das schiefgeht, sondern auch, wie du es richtig machst.
Die Kernlogik passt auf vier Zeilen:
- Crawling steuern: robots.txt
- Indexierung beeinflussen: Noindex
- Bevorzugte URL festlegen: Canonical
- Wichtige URLs bekannt machen: Sitemap
Wer diese vier Werkzeuge richtig versteht, verhindert viele technische SEO Fehler, bevor sie überhaupt entstehen.
Die wichtigsten Erkenntnisse aus diesem Guide sind folgende
- Crawlen und Indexieren sind zwei getrennte Schritte. Die meisten Verwechslungen entstehen genau hier.
- Ein Canonical ist ein starker Hinweis, aber kein Befehl, und es leitet niemanden weiter. Für dauerhaft ersetzte URLs nimmst du eine 301.
- Noindex muss gelesen werden können. Deshalb darf eine Seite mit noindex nicht in der robots.txt gesperrt sein.
- Die robots.txt ist kein Zugriffsschutz und kein Mittel zum Entfernen aus dem Index.
- Eine Sitemap garantiert keine Indexierung. Sie enthält nur kanonische, erreichbare, indexierbare URLs.
- Jede indexierbare Seite bekommt ein Self Referencing Canonical, Paginierungsseiten verweisen auf sich selbst.
- Zuerst die Entscheidung pro URL Typ treffen, dann die Technik wählen, und nach jedem Relaunch den Schnellcheck durchführen.
- Auch KI Crawler und KI Übersichten hängen an denselben Grundlagen: Was nicht gecrawlt und indexiert werden darf, taucht dort nicht auf.
Das kannst du heute noch tun
Ein Guide ist nur dann etwas wert, wenn danach etwas besser ist. Diese fünf Schritte schaffst du heute, und keiner dauert länger als zehn Minuten:
- Öffne deine robots.txt und prüfe, ob irgendwo Disallow mit einem einzigen Schrägstrich steht.
- Öffne deine Sitemap und schau dir zehn zufällige URLs an: Status 200, kein noindex, Canonical auf sich selbst?
- Prüfe deine drei wichtigsten Seiten im Quelltext auf Canonical und noindex.
- Schau in die Search Console unter Seitenindexierung und lies, welche Ausschlussgründe auftauchen.
- Speichere dir die Checkliste aus Kapitel 11 und plane für den nächsten Relaunch den Schnellcheck ein.
Wenn du dabei etwas findest, das nicht stimmt: Bleib ruhig. Die meisten dieser Fehler lassen sich in Minuten beheben, und sie tauchen bei fast jeder gewachsenen Website auf. Das ist keine Schande, sondern der Normalfall.
Wenn dir der Guide geholfen hat, teile ihn mit jemandem, der gerade über das Wort noindex gestolpert ist. Du ersparst ihm ein paar graue Haare.
Das beste zum Schluss
Die Beispiele wie die Website Gartenwissen und die geschilderten Szenarien sind typische, bewusst vereinfachte Fälle, keine Berichte über einzelne Kunden. Und weil Google Details gelegentlich ändert, etwa Bezeichnungen in der Search Console oder Zuständigkeiten einzelner Crawler, lohnt sich bei wichtigen Entscheidungen ein kurzer Blick in die aktuelle Dokumentation. Wenn du einen Fehler oder eine Änderung entdeckst, sag uns Bescheid, damit dieser Guide ein Evergreen bleibt.